New Relic 로깅 모범 사례 가이드에 오신 것을 환영합니다. 여기에서 로그 기능을 최적화하고 데이터 소비를 관리하는 방법에 대한 자세한 권장 사항을 찾을 수 있습니다.
팁
많은 로그가 있습니까? 최적화 및 관리 방법에 대한 자습서를확인하십시오.
전달 로그
다음은 로그 전달 문서 를 보완하기 위한 로그 전달에 대한 몇 가지 팁입니다.
로그를 전달할 때 New Relic 인프라 에이전트 및/또는 APM 에이전트 를 사용하는 것이 좋습니다. New Relic 에이전트를 사용할 수 없는 경우 지원되는 다른 에이전트(예: FluentBit, Fluentd 및 Logstash)를 사용하십시오.
지원되는 로깅 에이전트에 대한 몇 가지 Github 예제 구성은 다음과 같습니다.
중요
로그가 기본 호스트/컨테이너의 디렉터리에 저장되고 에이전트에서 리소스를 수집하여 로그를 수집하는 경우, 배포 에이전트와 에이전트 모두에서 수집된 중복 로그를 볼 수 있습니다. 중복 로그 전송을 방지하려면 이 가이드 의 권장 사항을 참조하세요.
전달하는 모든 데이터에
logtype속성을 추가합니다. 기본 제공 구문 분석 규칙을 사용하기 위한 속성은 required 이며 데이터 유형을 기반으로 사용자 정의 구문 분석 규칙을 생성하는 데에도 사용할 수 있습니다.logtype속성은 잘 알려진 속성으로 간주되며 퀵스타트 대시보드에서 요약 정보를 기록하는 데 사용됩니다.잘 알려진 로그 유형에 대해 내장된 구문 분석 규칙 을 사용하십시오. 관련
logtype속성을 설정하면 여러 잘 알려진 로그 유형의 로그를 자동으로 구문 분석합니다.다음은 인프라 에이전트가 전달한 로그에
logtype속성을 추가하는 방법의 예입니다.logs:- name: mylogfile: /var/log/mylog.logattributes:logtype: mylog다음과 같은 다른 일반적인 데이터 유형에 대한 로그를 전달하기 위해 New Relic 통합을 사용하십시오.
- 컨테이너 환경: Kubernetes(K8S)
- 클라우드 공급자 통합: AWS , Azure 또는 GCP
- 로깅과 지원되는 다른 모든 호스트 통합
데이터 분할
매일 상당한 양의 기록된 데이터를 사용하거나 사용할 계획이라면 기능적 및 주제별 그룹화를 제공하는 방식으로 데이터를 분할하는 계획을 포함하여 기록에 대한 수집 거버넌스 계획을 수립해야 합니다. 데이터 파티션을 올바르게 사용하면 상당한 성능 향상을 얻을 수 있습니다. 모든 로그를 단일 계정의 하나의 거대한 "버킷"(기본 로그 파티션)으로 보내는 경우 각 쿼리에 대한 결과를 반환하기 위해 계정의 모든 로그를 스캔해야 하므로 느리게Query 또는 실패한 쿼리가 발생할 수 있습니다. 자세한 내용은 NRQL 쿼리 속도 제한을 참조하세요.
쿼리 성능을 개선하는 한 가지 방법은 검색되는 시간 범위를 제한하는 것입니다. 장기간에 걸쳐 로그를 검색하면 더 많은 결과가 나오며 더 많은 시간이 필요합니다. 가능하면 장시간에 걸친 검색은 피하고, 시간 범위 선택기를 사용하여 검색 범위를 더 짧고 구체적인 시간 범위로 좁히세요.
검색 성능을 향상시키는 또 다른 방법은 데이터 파티션 을 사용하는 것입니다. 다음은 데이터 파티션에 대한 몇 가지 모범 사례입니다.
로그 온보딩 프로세스 초기에 파티션을 사용해야 합니다. 사용자가 특정 로그를 검색하고 찾는 위치를 알 수 있도록 파티션 사용 전략을 만듭니다. 이렇게 하면 나중에 로그 여정에서 파티션을 구현하는 경우 경고, 대시보드 및 저장된 보기를 수정할 필요가 없습니다.
환경이나 조직 내에서 정적이거나 거의 변경되지 않는 범주(예: 사업부, 팀, 환경, 서비스 등)에 맞춰 데이터 파티션을 만듭니다.
가장 일반적인 쿼리에 대해 스캔해야 하는 이벤트 수를 최적화하기 위해 파티션을 만듭니다. 수집 볼륨이 높으면 짧은 시간 창에 더 많은 이벤트가 발생하므로 긴 시간 동안 검색하면 시간이 더 오래 걸리고 잠재적으로 시간 초과가 발생할 수 있습니다. 엄격한 규칙은 없지만 일반적으로 "스캔된" 로그 이벤트는 5억 개가 넘습니다(특히 10억 개가 넘을 때). 일반적인 쿼리의 경우 분할을 조정하는 것이 좋습니다.
수집 볼륨이 낮은 경우에도 데이터를 논리적으로 분리하거나 개별 데이터 유형에서 쿼리 성능을 향상시키기 위해 데이터 파티션을 사용할 수도 있습니다.
Logs UI에서 데이터 파티션을 검색 하려면 적절한 파티션을 선택하고 파티션 선택기를 열고 검색하려는 파티션을 확인해야 합니다. NRQL을 사용하는 경우
FROM절을 사용하여 검색할Log또는Log_<partion>지정합니다. 예를 들어:FROM Log_<my_partition_name> SELECT * SINCE 1 hour ago또는 여러 파티션에서 로그를 검색하려면:
FROM Log, Log_<my_partition_name> SELECT * SINCE 1 hour ago
로그 데이터 액세스 보안
민감한 정보가 포함될 수 있는 로그 데이터를 사용하는 경우, 특정 로그에 누가 액세스할 수 있는지 제어하는 것이 중요합니다. 로그 데이터를 보호하기 위한 모범 사례는 다음과 같습니다.
데이터 액세스 제어 사용: 데이터 액세스 제어 정책을 구현하여 특정 로그 파티션을 볼 수 있는 사용자를 제한합니다. 특히 로그에 개인 식별 정보(PII), 보안 데이터 또는 비즈니스에 민감한 정보가 포함되어 있는 경우 이 점이 매우 중요합니다.
데이터 노출 위험에 주의하세요. 특정 기능은 데이터 접근 제한을 우회할 수 있습니다. 잠재적인 데이터 노출 위험을 검토하고 다음 모범 사례를 따르세요.
- Data partitions rules 기능에 대한 Modify 액세스 권한이 있는 사람을 제한합니다. 이를 통해 사용자는 파티션을 재구성하고 제한된 데이터에 액세스할 수 있습니다.
- 쿼리 키는 사용자 수준 데이터 액세스 제한을 우회할 수 있으므로 신뢰할 수 있는 관리자에게만 Query keys 기능에 대한 Modify 액세스를 제한합니다.
- 데이터 액세스 정책을 준수하지 않는 Insights API 키를 회전하거나 삭제합니다.
- 공지 조건 또는 공지를 통해 민감한 데이터에 액세스해서는 안 되는 사용자를 위해 알림 관리 기능 없이 사용자 정의 역할을 만듭니다.
액세스 제어를 통해 파티션 정렬: 파티션 전략을 계획할 때 어떤 팀이 어떤 로그에 액세스해야 하는지 고려하세요. 팀, 서비스 또는 민감도 수준별로 로그를 그룹화하여 액세스 제어 관리를 보다 쉽게 만듭니다.
파싱 로그
수집 시 로그인을 구문 분석하는 것은 귀하와 조직의 다른 사용자가 로그인 데이터를 더 쉽게 사용할 수 있도록 하는 가장 좋은 방법입니다. 속성을 파싱하면 쿼리 시 데이터를 파싱할 필요 없이 해당 속성을 사용하여 쉽게 Logs UI 및 NRQL에서 검색할 수 있습니다. 이를 통해 및 대시보드에서도 쉽게 사용할 수 있습니다.
로그를 구문 분석하려면 다음을 수행하는 것이 좋습니다.
수집 시 로그를 구문 분석하여 및 알림을 검색하거나 생성할 때 사용할 수 있는
attributes(또는 필드)를 생성합니다. 속성은 데이터 문자열 또는 숫자 값일 수 있습니다.다른 NRQL
WHERE절과 함께 수집 시 로그에 추가한logtype속성을 사용하여 구문 분석하려는 데이터와 일치시킵니다. 가능한 한 정확하게 로그를 필터링하기 위해 특정 일치 규칙을 작성합니다. 예를 들어:WHERE logtype='mylog' AND message LIKE '%error%'가능할 때마다 내장된 구문 분석 규칙 및 관련
logtype속성을 사용하십시오. 기본 제공 규칙이 데이터에 작동하지 않으면 다른logtype속성 이름(예:apache_logs대apache,iis_w3c_custom대iis_w3c)을 사용한 다음 다음에서 새 구문 분석 규칙을 만듭니다. 로그 데이터 형식에 맞게 작동하도록 기본 제공 규칙의 수정된 버전을 사용하는 UI입니다.Parsing UI를 사용하여 Grok 규칙을 테스트하고 검증하세요.
Paste log옵션을 사용하면 영구 구문 분석 규칙을 생성하고 저장하기 전에 로그 메시지 중 하나를 붙여넣어 Grok 표현식을 테스트할 수 있습니다.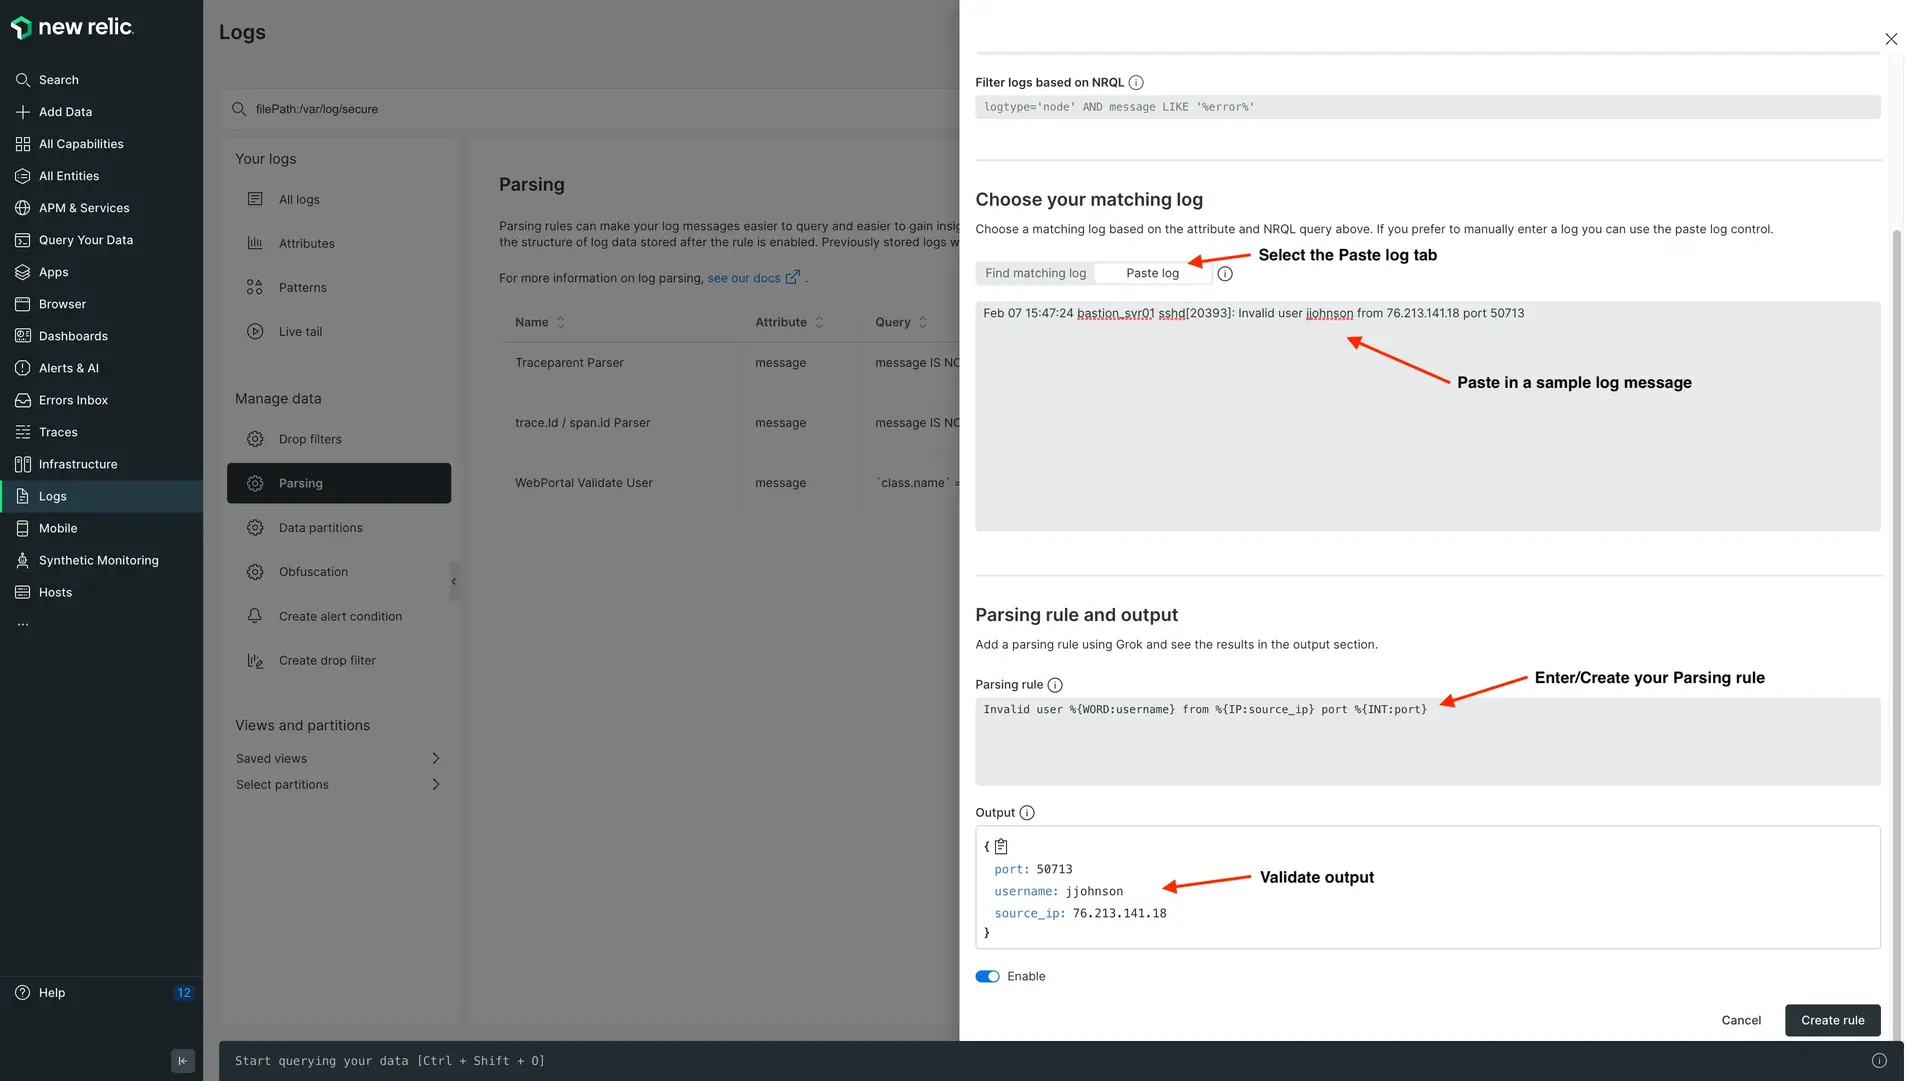
외부 FluentBit 구성을 사용하여 다중 라인 로그 구문 분석 및 New Relic에 수집하기 전에 기타 보다 광범위한 사전 구문 분석을 수행합니다. 인프라 에이전트를 사용한 다중 라인 구문 분석에 대한 자세한 내용 및 구성은 이 블로그 게시물 을 참조하십시오.
필터링된 로그와 일치하도록 최적화된 Grok 패턴을 생성하여 속성을 추출합니다. GREEDYDATA와 같은 고가의 Grok 패턴을 과도하게 사용하지 마십시오. 최적이 아닌 구문 분석 규칙을 식별하는 데 도움이 필요한 경우 New Relic 계정 담당자에게 문의하십시오.
GROK 모범 사례
- 추출할 속성 값의 유형을 지정하려면 Grok 유형을 사용하십시오. 생략하면 값이 문자열로 추출됩니다. 이러한 속성에서 NRQL 함수(즉,
monthOf(),max(),avg(),>,<등)를 사용할 수 있기를 원하는 경우 숫자 값에 특히 중요합니다. - Grok 패턴을 테스트하려면 Parsing UI를 사용하세요. Parsing UI에 샘플 로그를 붙여넣어 Grok 또는 Regex 패턴을 검증하고 예상대로 속성을 추출하는지 확인할 수 있습니다.
- 구문 분석 로직(즉,
^)에 앵커를 추가하여 줄의 시작을 나타내거나 줄의 끝에서$을 나타냅니다. - 패턴 주위에
()?를 사용하여 선택적 필드를 식별합니다. '%{GREEDYDATA}와 같은 값비싼 Grok 패턴을 과도하게 사용하지 마십시오. 속성을 추출할 때 항상 유효한 Grok 패턴과 Grok 유형을 사용하십시오.
드롭 필터 규칙
수집 시 로그 삭제
- 유용하지 않거나 대시보드, 경고 또는 문제 해결에 대한 사용 사례를 충족하는 데 필요하지 않은 로그를 삭제하는 삭제 필터 규칙 을 만듭니다.
수집 시 로그에서 속성 삭제
- 로그에서 사용하지 않는 속성을 삭제하려면 삭제 규칙을 만드세요.
- 구문 분석 후
message속성을 삭제합니다. 데이터에서 새 속성을 생성하기 위해 메시지 속성을 구문 분석하는 경우 메시지 필드를 삭제하십시오. - 예: AWS 인프라에서 데이터를 전달하는 경우 원치 않는 데이터 팽창을 생성할 수 있는 AWS 속성을 삭제하는 삭제 규칙을 생성할 수 있습니다.
New Relic 로그 크기 조정
스토리지 비용 청구 방식은 일부 경쟁업체와 다를 수 있습니다. 로그 데이터를 측정하는 방법은 사용량 계산 에 정의된 다른 유형의 데이터를 측정하고 요금을 청구하는 방법과 유사합니다.
클라우드 통합(AWS, Azure, GCP)이 설치된 경우 모든 로그 레코드에 클라우드 메타데이터를 추가하여 전체 수집 청구서에 추가합니다. 수집을 줄이기 위해 이 데이터를 삭제할 수 있습니다.
로그 데이터 오버헤드의 주요 동인은 영향 순서대로 다음과 같습니다.
- 클라우드 통합
- JSON 형식
- 로그 패턴( Logs UI에서 패턴을 비활성화/활성화 할 수 있습니다.)
로그 검색
일반적인 로그 검색의 경우 UI에서 Saved views 생성하고 사용합니다. 데이터에 대한 검색을 생성하고 + Add Column 클릭하여 UI 테이블에 추가 속성을 추가합니다. 그런 다음 원하는 순서대로 표시되도록 열을 이동한 다음 개인 또는 공용 권한을 사용하여 저장된 보기로 저장할 수 있습니다. 귀하와 다른 사용자가 관련된 모든 속성 데이터가 표시된 일반 검색을 쉽게 실행할 수 있도록 저장된 보기를 공개로 구성하십시오. 이는 apache, nginx 등과 같은 타사 애플리케이션에 대한 좋은 방법이므로 사용자는 검색하지 않고도 해당 로그를 쉽게 볼 수 있습니다.
NRQL의 고급 기능을 활용하여 쿼리 빌더를 사용하여 검색을 실행합니다. 여러 계정의 로그를 쿼리하고 해당 계정 ID로 식별하려면 NRQL 쿼리의
SELECT문에accountId() as accountId포함합니다.만들거나 사용 가능한 퀵스타트 대시보드를 사용하여 로그인에 대한 일반적인 질문에 답하고 시간 경과에 따른 기록 데이터를 시계열 그래프로 살펴보세요. 여러 패널이 포함된 대시보드를 만들어 다양한 방법으로 로그 데이터를 분류하세요.
capture() 또는 aparse() 와 같은 고급 NRQL 기능을 사용하여 검색 시 데이터를 구문 분석합니다.
로그인 데이터에 더 많은 인사이트를 빠르게 추가하려면 Logs analysis 및/또는 APM logs monitoring quickstart 대시보드를 설치하세요. 이러한 대시보드를 추가하려면 one.newrelic.com > Integrations & Agents > Logging > Dashboards 로 이동하세요.
다음은 뭐지?
시작하기를 참조하세요.