Dans le 1er tutoriel NRQL, nous avons exploré les principes fondamentaux de la création de requêtes. Nous avons abordé la structure de base d’une requête, la définition des fenêtres de temps, et la manière de sélectionner des attributs spécifiques à observer. Nous avons également appris à commencer à agréger et à afficher des données à l’aide de graphiques et d’autres visualisations.
Dans ce didacticiel, nous allons approfondir un peu plus et explorer davantage de fonctions pour créer des agrégations utiles. Ici, vous apprendrez à comparer les données renvoyées avec les périodes précédentes et à regrouper les données dans des fenêtres temporelles spécifiques. Vous trouverez également encore plus de choses à faire avec les fonctionnalités SINCE et UNTIL et explorerez l'utilisation des caractères génériques dans les filtres. Plus précisément, vous apprendrez à :
- requête pour la valeur unique en utilisant
uniques(attributeName) - Déterminez combien de valeurs uniques existent dans un attribut en utilisant
uniqueCount(attributeName) - Récupérer les
earliest(attributeName)etlatest(attributeName)dans une fenêtre de temps spécifique - Calculez des pourcentages basés sur un qualificateur, ou un autre point de données avec
percentile() - Effectuer des calculs mathématiques de base à l'aide de fonctions d'attribut et d'agrégation, ou d'une combinaison des deux
- Convertissez les noms d'attributs en quelque chose de personnalisé et de plus lisible
- Recherchez pour inclure/exclure à l’aide de caractères génériques avec
LIKEouNOT LIKE, ou limitez les résultats à ceuxINune liste ouNOT INcette liste - requête dans des fenêtres temporelles plus avancées utilisant des dates, des époques et
WITH TIMEZONE - Regroupez les données dans des fenêtres temporelles à l’aide de cohortes temporelles
C'est parti !
Fonctions d'agrégation
Après avoir terminé le premier tutoriel NRQL, vous avez utilisé count(), average(), sum(), max() et min() pour transformer vos données de manière significative. Mais que faire si vous souhaitez trouver et compter des valeurs uniques ? Pour trouver le nombre de valeurs uniques enregistrées pour un attribut sur une plage de temps spécifiée, vous pouvez utiliser la fonction uniqueCount(). Il vous suffit de fournir l'attribut que nous voulons inspecter comme argument. Par exemple, voici une requête pour afficher tous les appels d'API publics uniques :
SELECT uniqueCount(http.url) FROM Public_APICall SINCE 1 day ago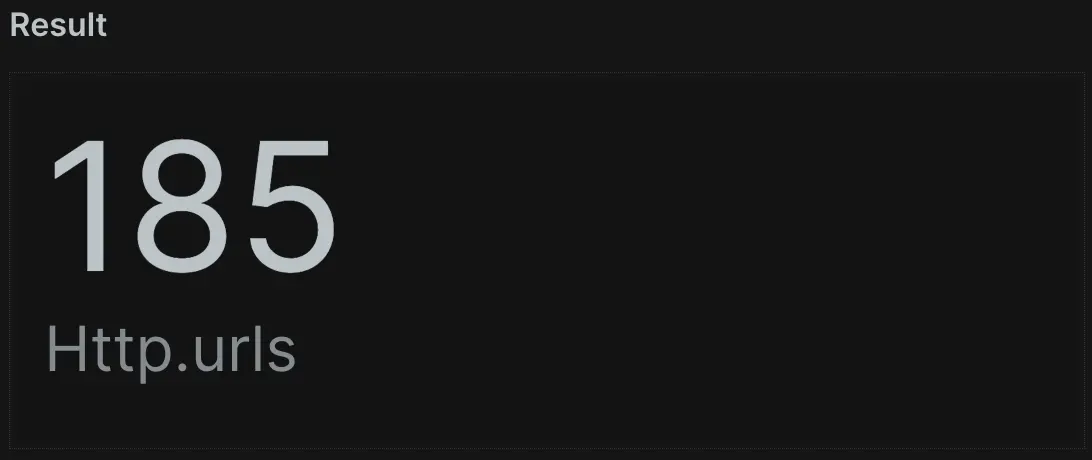
Pour optimiser les performances des requêtes, la fonction ci-dessus renvoie des résultats approximatifs pour les requêtes qui inspectent plus de 256 valeurs uniques. Pour renvoyer la liste réelle des valeurs uniques pour un attribut sur une plage de temps spécifiée, nous pouvons utiliser la fonction uniques() .
SELECT uniques(http.url) FROM Public_APICall SINCE 1 day agoPour spécifier une valeur limite différente de la valeur par défaut de 1000, utilisez uniques(attribute[,limit]), qui accepte un maximum de 10 000.
Pour récupérer la valeur la plus récente d'un attribut sur une plage de temps spécifiée, utilisez la fonction latest() . Dans cet exemple de requête, vous pouvez localiser les temps de réponse les plus récents pour un appel d'API au cours du dernier jour. Cela pourrait vous aider à localiser la valeur la plus récente d'une transaction ou d'un service signalé par intermittence.
SELECT latest(duration) FROM Public_APICall WHERE awsAPI = 'sqs' SINCE 1 day ago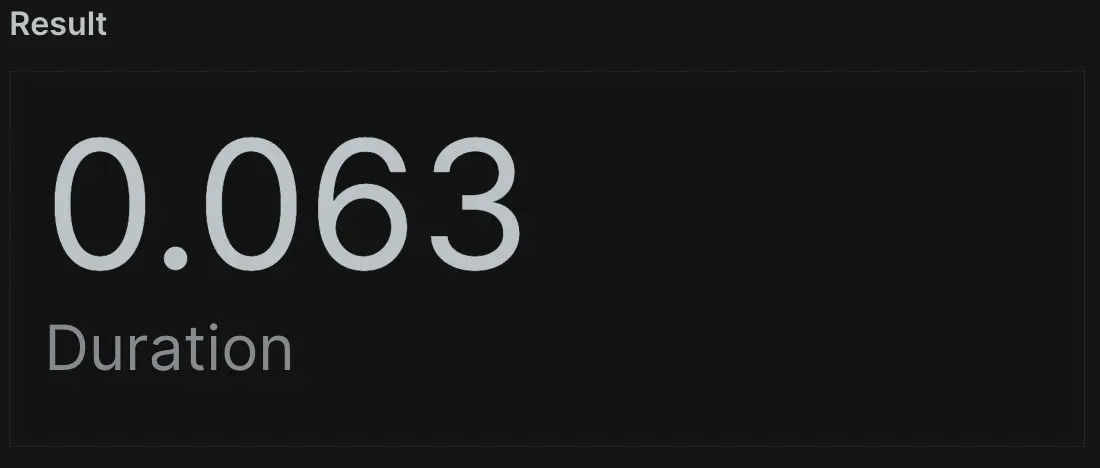
À l’autre bout du spectre, vous pourriez utiliser la fonction earliest() pour obtenir l’effet inverse. Il renverra la valeur la plus ancienne d'un attribut enregistré dans la plage de temps spécifiée. Dans cet exemple de requête, vous pouvez récupérer les temps de réponse les plus anciens pour un appel d'API au cours du dernier jour. Si les données sont rapportées de manière cohérente, cela signalera le point de données de l'événement le plus ancien au cours des dernières 24 heures.
SELECT earliest(duration) FROM Public_APICall WHERE awsAPI = 'sqs' SINCE 1 day ago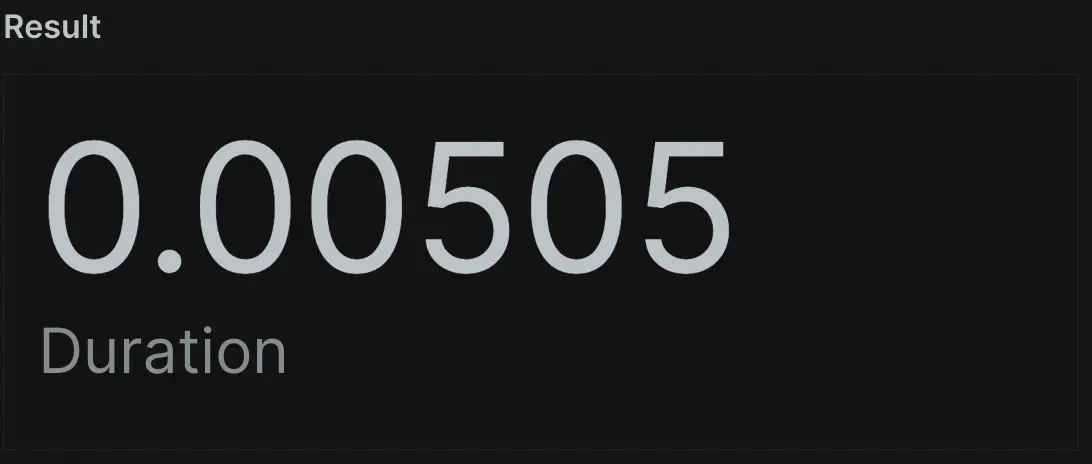
Vous constaterez peut-être que vous avez besoin de pourcentages au lieu de comptages, de sommes, ou de moyennes. L’utilisation de la fonction percentage() vous permet de calculer le pourcentage d’une valeur dans le dataset qui correspond à une condition spécifiée. Cette fonction prend deux arguments : le premier est une fonction d’agrégateur pour votre attribut souhaité, telle que count(). Le second est une condition WHERE pour spécifier le sous-ensemble de données que vous souhaitez soumettre à une requête.
Dans cet exemple de requête, vous pouvez trouver le pourcentage d'appels d'API au cours du dernier jour qui ont eu une durée (ou temps de réponse) supérieure à 100 millisecondes.
SELECT percentage(count(*), WHERE duration > 0.1) FROM Public_APICall SINCE 1 day ago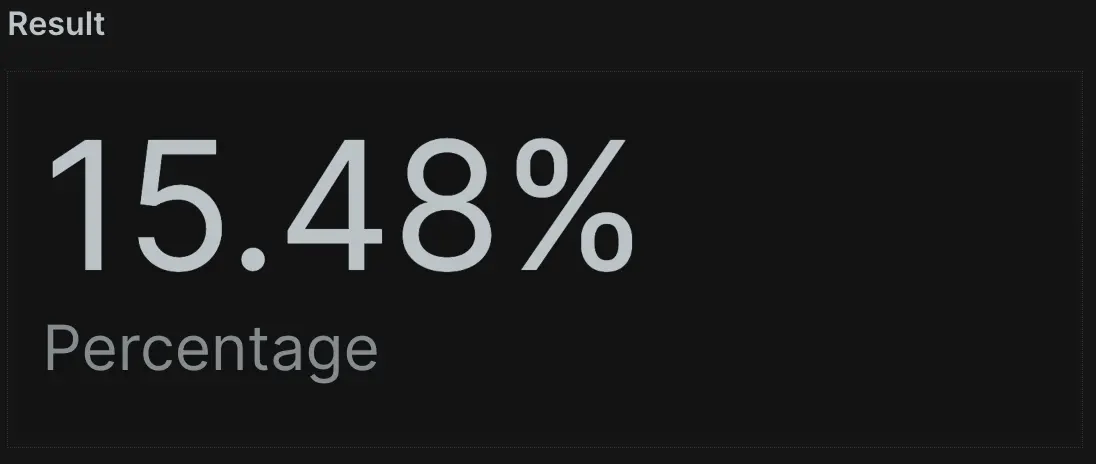
Il est très courant de visualiser les performances des applications ou les données d'expérience client en utilisant des centiles plutôt que des moyennes. Vous pouvez utiliser la fonction percentile() pour comprendre l’expérience du n-ième percentile.
Par exemple, disons que vous souhaitez savoir quelle a été la pire expérience (durée la plus élevée) de 98 % de vos clients au cours de la dernière journée. Vous pouvez demander à NRDB percentile(duration, 98) des dernières 24 heures.
SELECT percentile(duration,98) FROM Public_APICall SINCE 1 day ago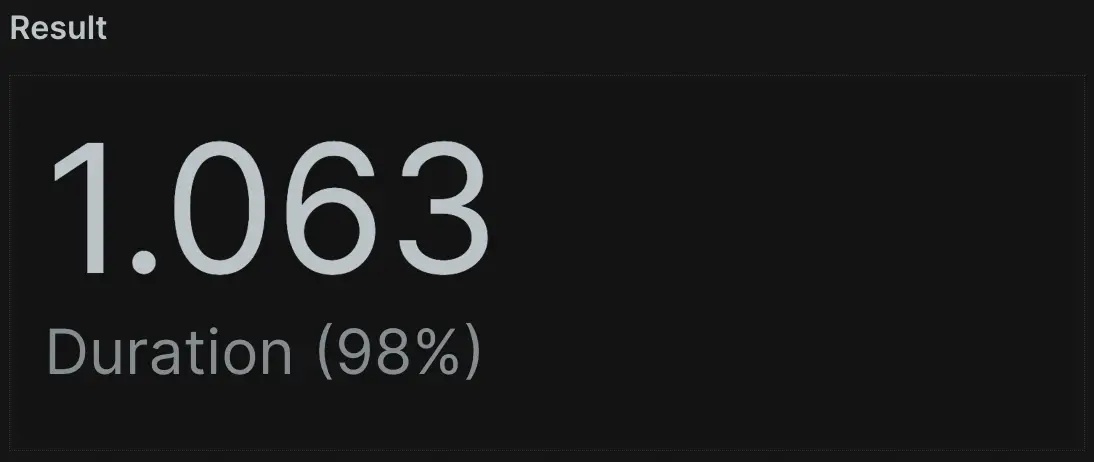
Comme vous pouvez le constater, l’agrégation vous donne un contrôle flexible sur vos données. Vous pouvez utiliser uniqueCount() pour compter les entrées uniques d’un attribut particulier. Mais vous pourriez également l’utiliser pour identifier un nombre de machines uniques, de conteneurs de reporting, ou même combien de points de données personnalisés vous envoyez à New Relic. Et, si vous souhaitez savoir quelles valeurs uniques sont disponibles pour une requête, vous pouvez toujours demander une liste en utilisant uniques().
Les fonctions latest() et earliest() sont particulièrement utiles lorsque vous traitez des données éparses, ou lorsque vous cherchez à déterminer quand un élément a commencé ou cessé de transmettre des données (en supposant que New Relic stocke toujours les données). La fonction percentage() peut vous indiquer quel pourcentage d’événements correspondait à un qualificateur par rapport à l’ensemble des résultats globaux. Enfin, vous pouvez utiliser percentile() comme indicateur de performances clés en fixant un objectif pour vous assurer que 90 % de toutes les transactions des utilisateurs finaux dépassent la durée fournie.
À l’étape suivante, vous apprendrez à effectuer des mathématiques de base avec NRQL.
Utiliser les opérateurs mathématiques
NRQL prend en charge les opérateurs mathématiques de base. Vous pouvez effectuer des additions (+), des soustractions (-), des multiplications (*), et des divisions (/) à la fois sur les valeurs d’attribut numériques et sur les résultats des fonctions d’agrégateur.
Par exemple, nous capturons à la fois le temps de réponse total (en tant que duration) et le temps de réponse de la base de données (en tant que databaseDuration) lorsque nous enregistrons un événement de transaction. Mais que faire si vous souhaitez trouver le temps moyen passé en dehors du traitement de la base de données ? Vous pourriez commencer par calculer cette valeur pour chaque événement de votre dataset à l’aide d’une requête telle que celle-ci.
SELECT GigabytesIngestedBillable - GigabytesIngestedFree, metric FROM NrMTDConsumption WHERE productLine IS NOT NULLSuper ! Vous venez d’effectuer des calculs mathématiques de base. Cela est utile pour vous aider à lister des événements individuels. Mais que faire si vous souhaitez connaître la durée moyenne des transactions sans le temps de la base de données ? Vous pouvez également faire de l’arithmétique dans la fonction :
SELECT average(GigabytesIngestedBillable - GigabytesIngestedFree) FROM NrMTDConsumption WHERE GigabytesIngestedBillable IS NOT NULLEt maintenant, que se passerait-il si vous vouliez rendre les choses encore plus compliquées en soustrayant, divisant et multipliant dans la même requête pour déterminer la durée sans temps de base de données, en pourcentage du temps global ? Eh bien, vous pouvez ajouter les mathématiques :
SELECT average(GigabytesIngestedBillable - GigabytesIngestedFree) / unitPrice * 100 FROM NrMTDConsumption WHERE GigabytesIngestedBillable IS NOT NULLNew Relic rapporte les temps d’exécution dans le cadre de vos événements, vous pouvez donc les utiliser pour calculer des points de données, ou même générer des résultats en pourcentage. Vous pouvez aller plus loin en appliquant ces opérateurs mathématiques à des actions ou événements personnalisés, ou à des données personnalisées que vous envoyez à New Relic. Par exemple, une plateforme e-commerce qui rapporte des données sur la taille des commandes et les méthodes de paiement pourrait utiliser des mathématiques pour calculer des éléments tels que le taux de conversion des commandes par rapport aux visites uniques de clients.
À l’étape suivante, vous apprendrez à utiliser NRQL pour étiqueter votre attribut.
Attribut d'étiquette
À mesure que vous commencez à exécuter des fonctions NRQL plus complexes, vous vous demandez peut-être si vous pouvez rendre les noms affichés pour les attributs de requête plus utiles, en particulier pour ceux qui ne connaissent pas NRQL. Prenons un exemple utilisant ce que vous avez appris dans le tutoriel précédent.
SELECT average(duration-externalDuration) FROM TransactionVous pouvez utiliser la clause AS après une fonction ou un attribut pour donner au résultat un nom plus lisible et plus significatif. Cela vous aide, vous et votre équipe, à comprendre exactement ce qu’un graphique représente.
SELECT average(duration-externalDuration) AS 'Non-External Response Time' FROM TransactionCela peut sembler simplement esthétique, mais lorsque vous créez un dashboard détaillé, il est important d’étiqueter clairement vos données. Cela rend la source de données claire pour quiconque consulte vos widget, vos panneaux d’affichage, vos graphiques linéaires, ou vos tableaux.
Nous y reviendrons dans une prochaine leçon sur le regroupement, pour découvrir comment AS peut également créer des ensembles de résultats propres dans des scénarios plus avancés. Ensuite, vous apprendrez à comparer des données dans différentes fenêtres temporelles.
Comparer les fenêtres temporelles
Vous avez maintenant l’habitude d’utiliser des plages de temps avec les clauses SINCE et UNTIL . Mais que faire si vous souhaitez comparer des valeurs provenant de différentes plages de temps ? Vous pouvez y parvenir avec la clause COMPARE WITH .
NRQL utilise SINCE et UNTIL pour définir une période d'intérêt. Ensuite, vous pouvez indiquer la période que vous souhaitez comparer en utilisant une clause COMPARE WITH [time period] AGO contenant une valeur de décalage relative.
Par exemple, dans l'exemple de requête ci-dessous, vous pouvez comparer les données du dernier jour avec les données de la semaine précédente en utilisant un décalage relatif d'il y a 1 semaine.
SELECT average(duration) FROM Public_APICall SINCE 1 day ago COMPARE WITH 1 week ago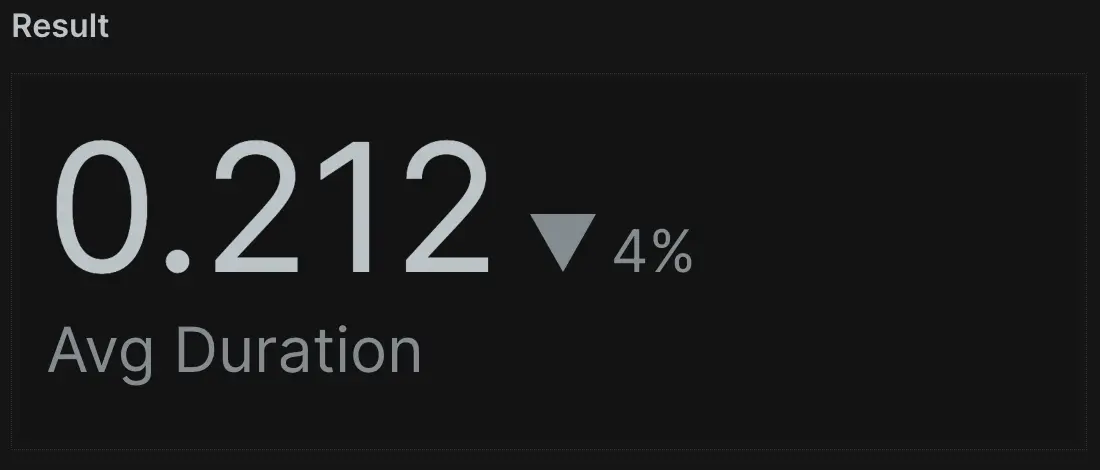
Pour cartographier la comparaison des valeurs au fil du temps, ajoutez TIMESERIES. Cela crée un graphique linéaire de la comparaison, vous permettant de visualiser comment cette période se compare aux données récentes et de la suivre au fil du temps.
SELECT average(duration) FROM Public_APICall SINCE 1 day ago COMPARE WITH 1 week ago TIMESERIES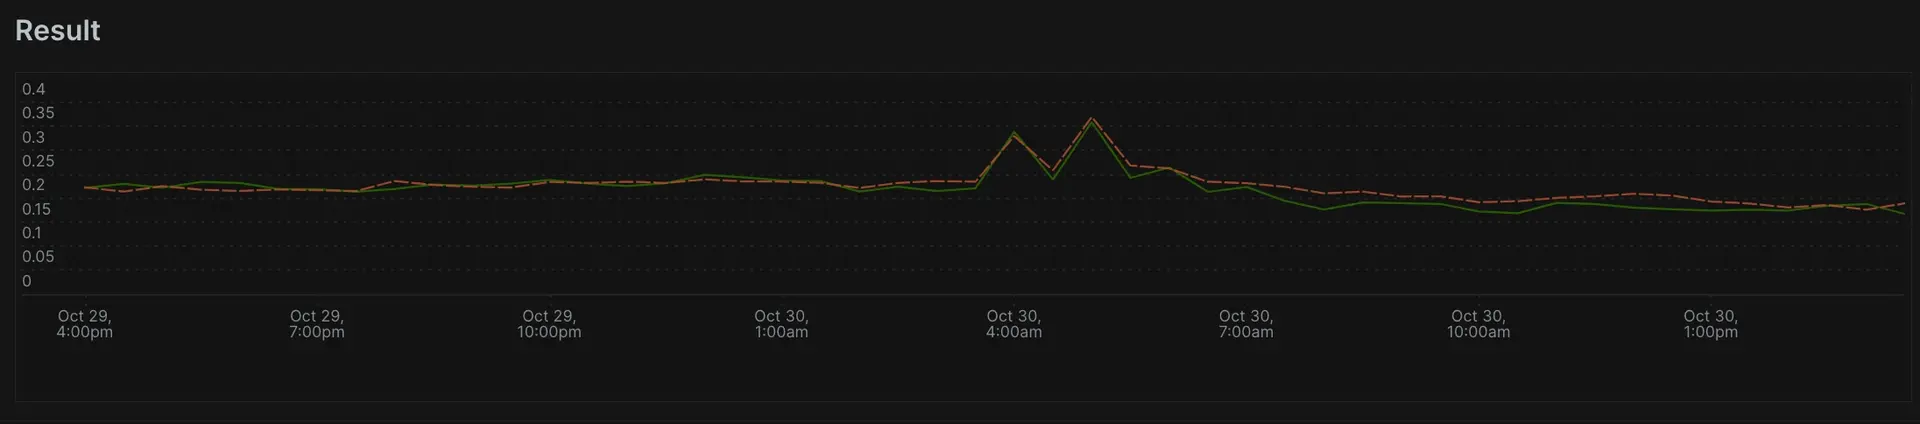
Vous pouvez également spécifier plusieurs périodes de temps relatives différentes dans le même format, similaire à UNTIL. Par instance, vous pouvez spécifier 4 WEEKS AGO ou 6 HOURS AGO.
SELECT average(duration) FROM Public_APICall SINCE 1 hour ago COMPARE WITH 6 hours ago TIMESERIESLes comparaisons peuvent répondre rapidement aux questions sur ce qu’il se passe dans vos applications. Les différentes valeurs de ventes, de performances, de MTTR, ou d’erreurs sont-elles en hausse ou en baisse par rapport à la semaine dernière ? Et, si vous enquêtez sur un problème, vous trouverez utile de comparer une période de performances problématiques à une période de performances normales.
Utiliser des filtres génériques
Vous savez maintenant comment utiliser une clause WHERE pour filtrer les résultats de notre requête. Outre l'utilisation d'opérateurs de comparaison standard, vous pouvez également utiliser LIKE et NOT LIKE si vous souhaitez déterminer si un attribut contient ou non une sous-chaîne spécifiée. Pour ce faire, vous pouvez utiliser le symbole de pourcentage (%) comme caractère générique n’importe où dans la chaîne.
Dans notre exemple de requête, vous pouvez obtenir le nombre de transactions contenant le terme "amazonaws" n’importe où (au début, au milieu, ou à la fin) dans le nom.
SELECT count(*) FROM Public_APICall WHERE http.url LIKE '%amazonaws%' FACET http.url SINCE 1 day ago
Si vous modifiez votre requête pour utiliser NOT LIKE à la place, vous obtiendrez le nombre de transactions qui ne contiennent pas le mot choisi (tel que « google », comme ci-dessous) dans leur nom.
SELECT count(*) FROM Public_APICall WHERE http.url NOT LIKE '%google%' FACET http.url SINCE 1 day ago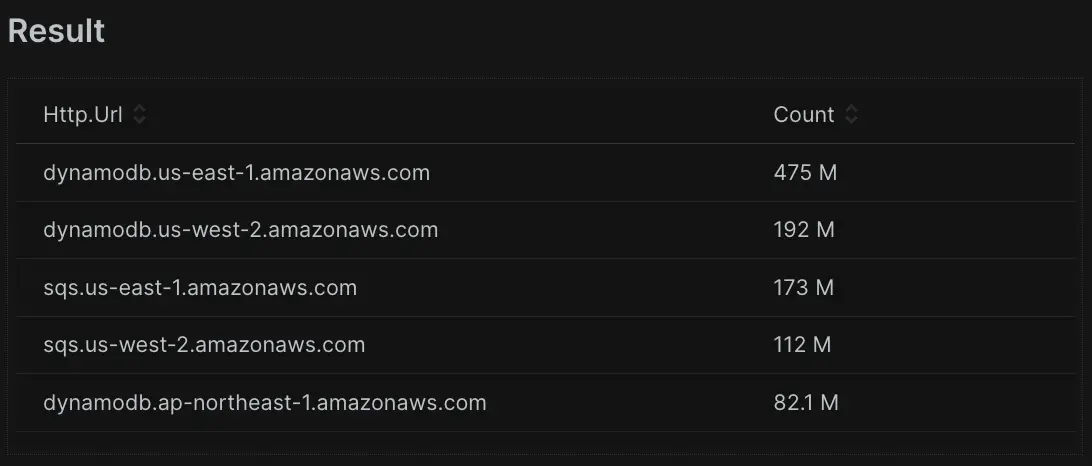
Vous pouvez utiliser % comme caractère générique au début et à la fin, ce qui signifie que New Relic vérifie si la valeur de l’attribut que vous avez choisi contient le terme, tel que "Web" n’importe où dans le texte. De même, vous pourriez utiliser %Web OU Web% pour faire correspondre un élément qui se termine par "Web" ou commence par "Web", respectivement.
Vous pouvez également ajouter le caractère générique entre les chaînes pour une recherche plus précise. Cette requête recherche un nom de transaction qui contient le mot « amazon » suivi de n'importe quel texte, mais qui contient également le terme « .com » suivi d'un nombre quelconque de caractères. Ainsi, les résultats ne seront que des transactions avec « amazon » et « .com » dans le nom.
SELECT count(*) FROM Public_APICall WHERE http.url NOT LIKE '%amazon%.com' FACET http.url SINCE 1 day ago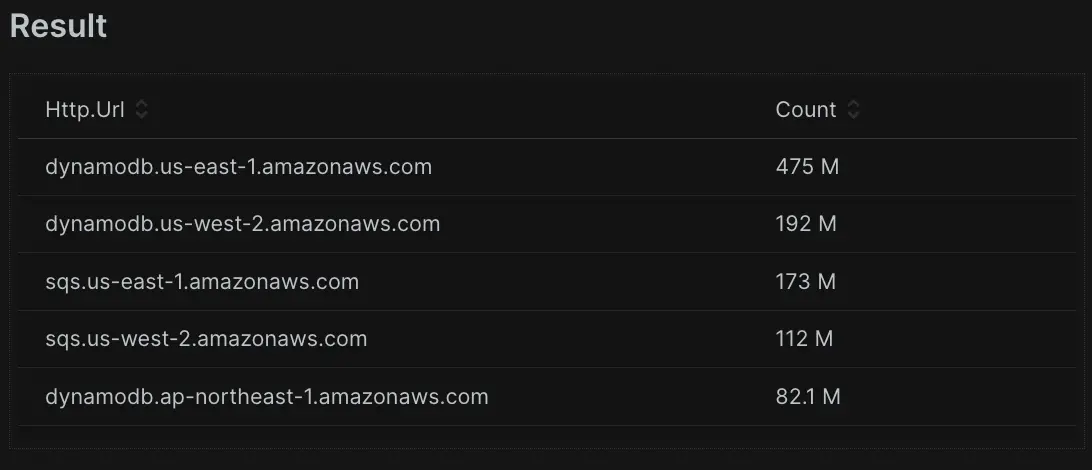
Que faire si vous avez besoin d'une spécificité extrême et que les noms n'ont pas de chaîne commune que vous pouvez faire correspondre à l'aide de caractères génériques ? Les opérateurs IN et NOT IN vous permettent de spécifier un ensemble de valeurs que vous souhaitez vérifier par rapport à un attribut. Au lieu de spécifier plusieurs clauses WHERE avec les opérateurs AND ou OR , vous pouvez simplifier une condition en répertoriant les valeurs entre parenthèses séparées par des virgules.
Dans cet exemple de requête, vous pouvez compter le nombre de transactions dont le sous-type est « graph.microsoft.com » ou « s3.amazonaws.com ». Si vous modifiez la requête pour utiliser NOT IN à la place, vous obtiendrez le nombre de transactions dont le sous-type n'est ni « graph.microsoft.com » ni "s3.amazonaws.com".
SELECT count(*) FROM Public_APICall WHERE http.url IN ('graph.microsoft.com', 's3.amazonaws.com') SINCE 1 day ago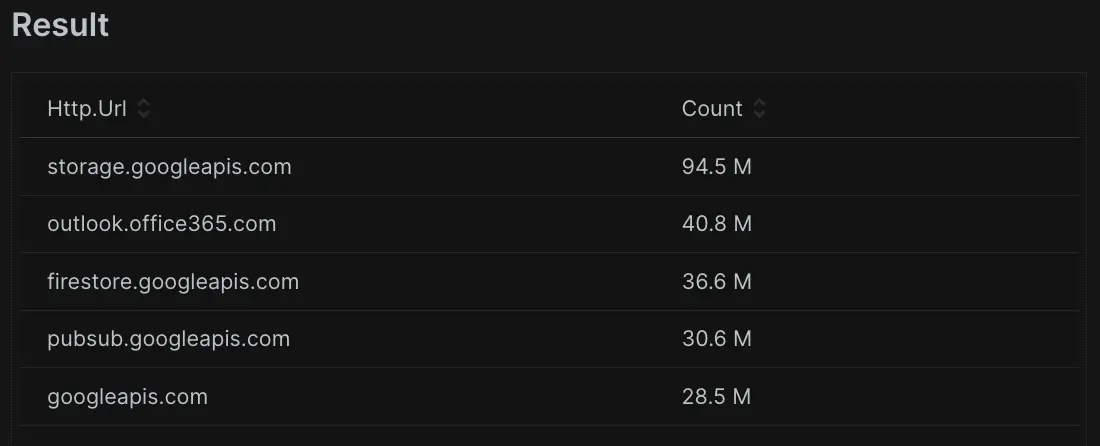
Vous pouvez désormais contrôler vos données et les manipuler pour faire ce dont vous avez besoin, ce qui vous permet de créer des dashboards et des alertes. Ensuite, vous apprendrez à spécifier des plages horaires à l’aide de NRQL.
Spécifier les plages horaires
Les clauses SINCE et UNTIL font plus que vous donner des informations sur les plages de temps relatives : vous pouvez également leur fournir une date ou une heure spécifique. Dans l’exemple de requête suivant, vous pouvez utiliser une date SINCE au format YYYY-MM-DD.
SELECT average(duration) FROM Public_APICall SINCE '2023-10-28' TIMESERIES MAX
Vous pouvez l’utiliser pour créer des rapports SLA pour une période de temps spécifiée. Vous pouvez même inclure une heure spécifique avec le format YYYY-MM-DD HH:MM. Dans cette requête, vous pouvez voir que les données sont définies à 18 h 00.
SELECT average(duration) FROM Public_APICall SINCE '2023-10-28 18:00' TIMESERIES MAX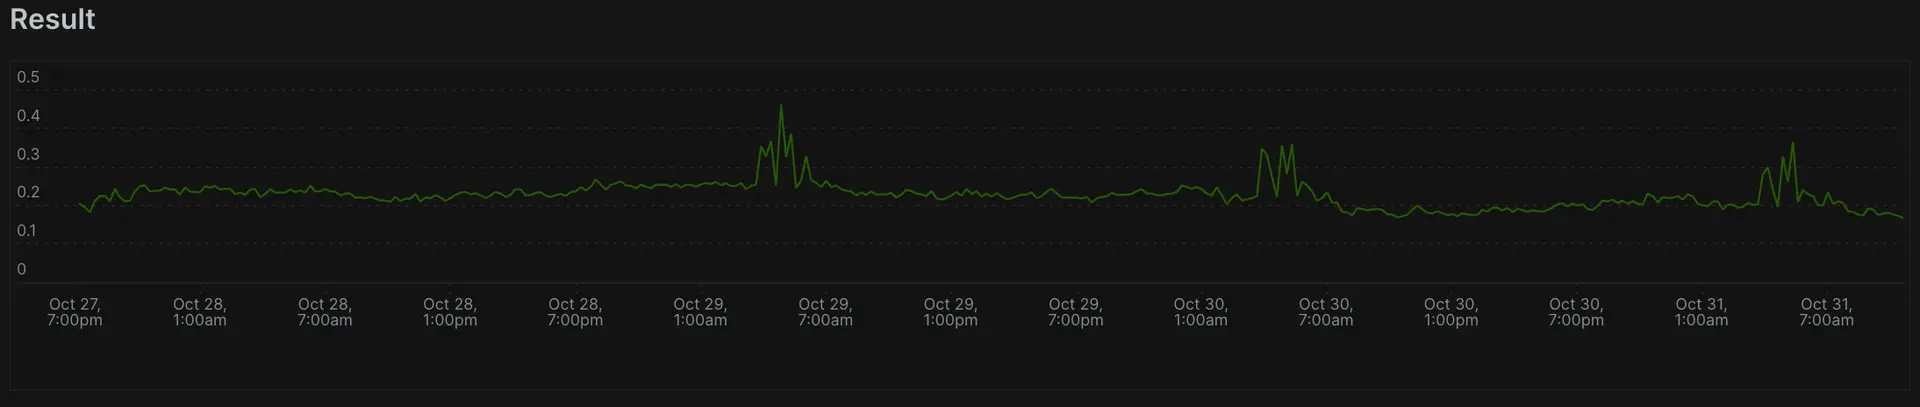
Parfois, vous pouvez recevoir une heure d’événement au format epoch (unix). Vous pouvez également utiliser des horodatages epoch avec les clauses SINCE et UNTIL afin de ne pas avoir à convertir manuellement ces valeurs dans un autre format de date.
SELECT average(duration) FROM Public_APICall SINCE 1698525489519 UNTIL 1698698289519 TIMESERIES MAX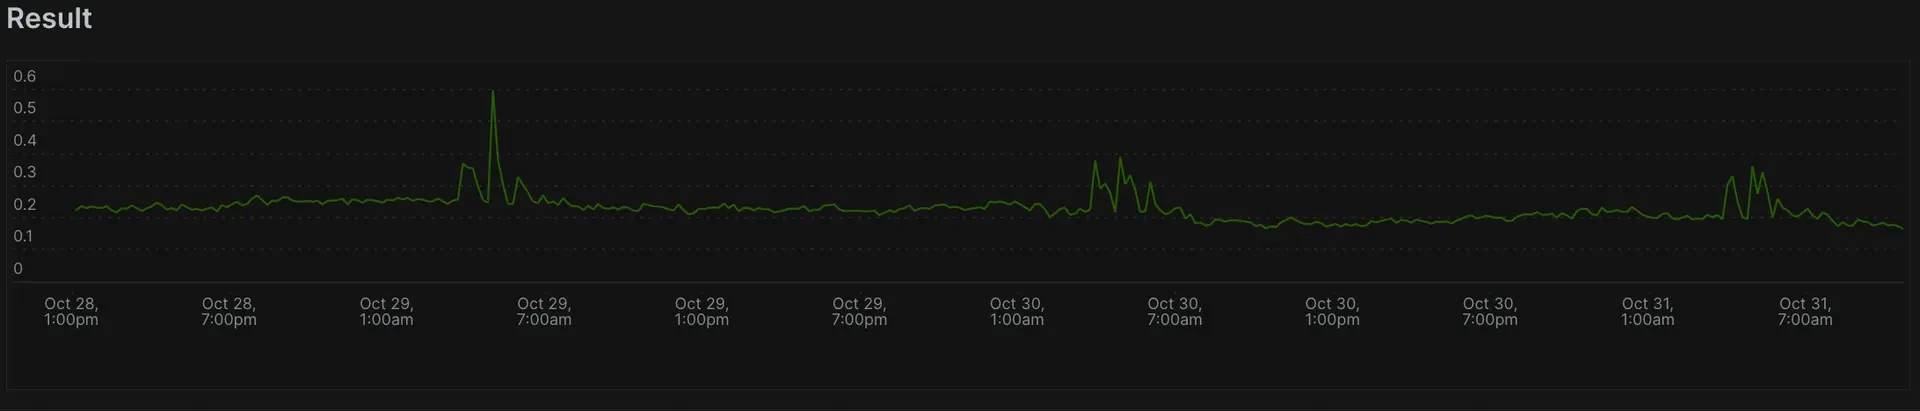
Lorsque NRDB affiche des données sur une période donnée, il suppose que vous souhaitez voir les données du point de vue de votre fuseau horaire. Mais avec des équipes internationales dispersées, votre aujourd'hui pourrait être le demain ou le hier d'un coéquipier, selon leur emplacement. Vous pouvez utiliser la clause WITH TIMEZONE pour définir un fuseau horaire à partir duquel afficher les données. Cela affecte l'interprétation des valeurs dans les clauses SINCE et UNTIL .
Considérez les deux exemples de graphiques ci-dessous. Chaque requête a un fuseau horaire spécifié à l'aide de WITH TIMEZONE. Les deux sont à 8 heures d'intervalle. Notez que le modèle de données est le même, mais décalé de 8 heures pour s'aligner sur chaque fuseau horaire respectif :
SELECT count(*) FROM Public_APICall SINCE yesterday UNTIL today WITH TIMEZONE 'America/Los_Angeles' TIMESERIES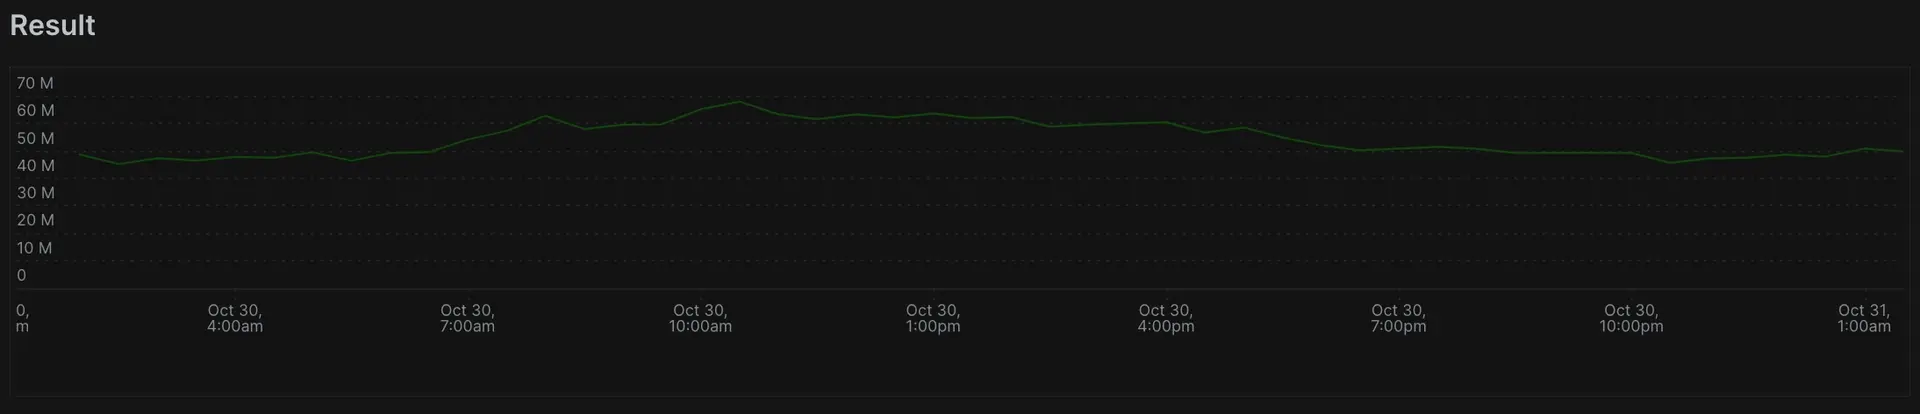
SELECT count(*) FROM Public_APICall SINCE yesterday UNTIL today WITH TIMEZONE 'Europe/London' TIMESERIES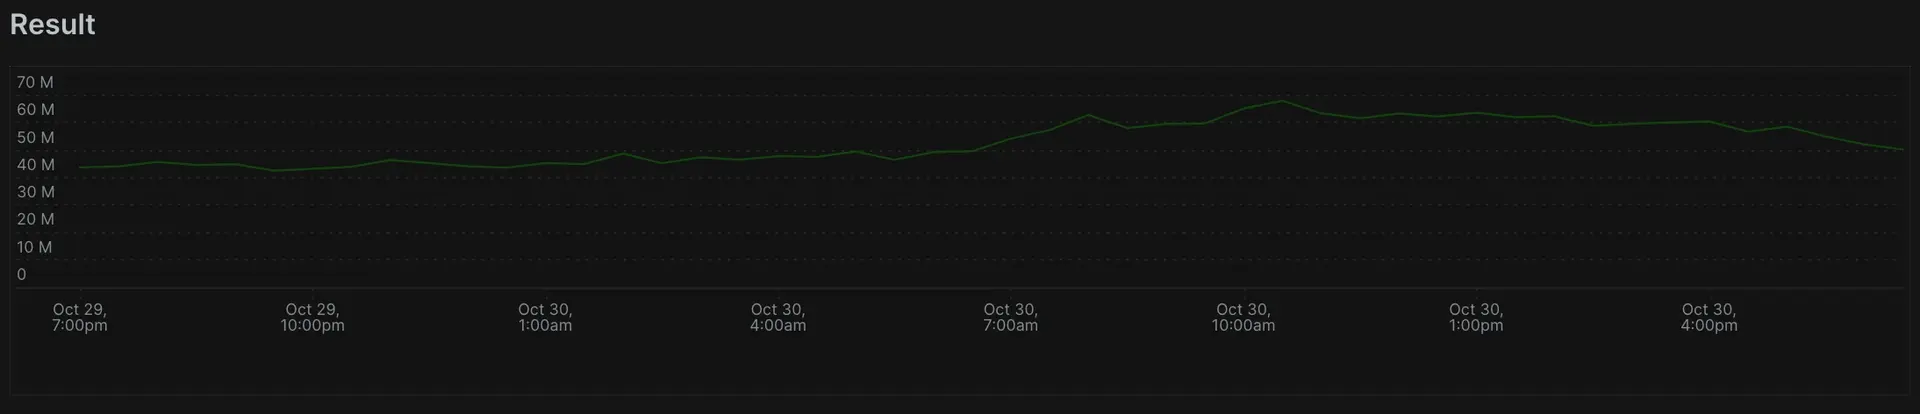
Avant cette leçon, tous vos mécanismes de contrôle du temps dépendaient de temps relatifs par rapport à maintenant. Désormais, vous pouvez ajuster la vue en fonction de l’emplacement d’une personne dans le monde. Peut-être qu’un client sur la côte Est signale un problème à votre équipe d’ingénierie située sur la côte Ouest. Votre équipe peut créer un dashboard, et traduire la vue pour correspondre au fuseau horaire tel que des clients le citeraient. Ainsi, si un client signale un problème à 9 h 00 sur la côte Est, vous pouvez vous assurer, lorsque vous regardez à 9 h 00, que vous n’avez pas à traduire mentalement la différence.
Lorsque vous devez vous concentrer sur des dates spécifiques d’un événement d’alerte et que vous souhaitez examiner les données sans fenêtre temporelle glissante par rapport à l’heure actuelle, cela vous aidera à obtenir des données dans une fenêtre temporelle statique. Dans la prochaine et dernière leçon, vous continuerez d’apprendre à utiliser le temps dans vos rapports avec les cohortes temporelles.
Utilisez des cohortes temporelles
Même si cela peut paraître complexe, la cohorte basée sur le temps signifie simplement un moyen d'organiser les données en groupes basés sur le temps tels que minuteOf, hourOf, weekOf, etc.
Lorsque vous utilisez la clause SINCE pour des durées, vous récupérez toute la durée de la requête. Mais ces données ne racontent pas toujours toute l’histoire ! Et si vous avez besoin d’analyser de plus près les performances sur une période donnée ? Avec le regroupement par cohortes temporelles, vous pouvez trier davantage les données en groupes logiques basés sur le temps.
En utilisant une combinaison de FACET et l'une des nombreuses fonctions basées sur le temps (telles que hourOf(timestamp)), vous pouvez prendre une semaine de données et comprendre les performances en fonction de l'heure spécifique à laquelle elles se sont produites. Cela révèle les tendances et identifie les moments les plus critiques pour vos applications :
SELECT average(duration) FROM Public_APICall FACET hourOf(timestamp) SINCE 1 week ago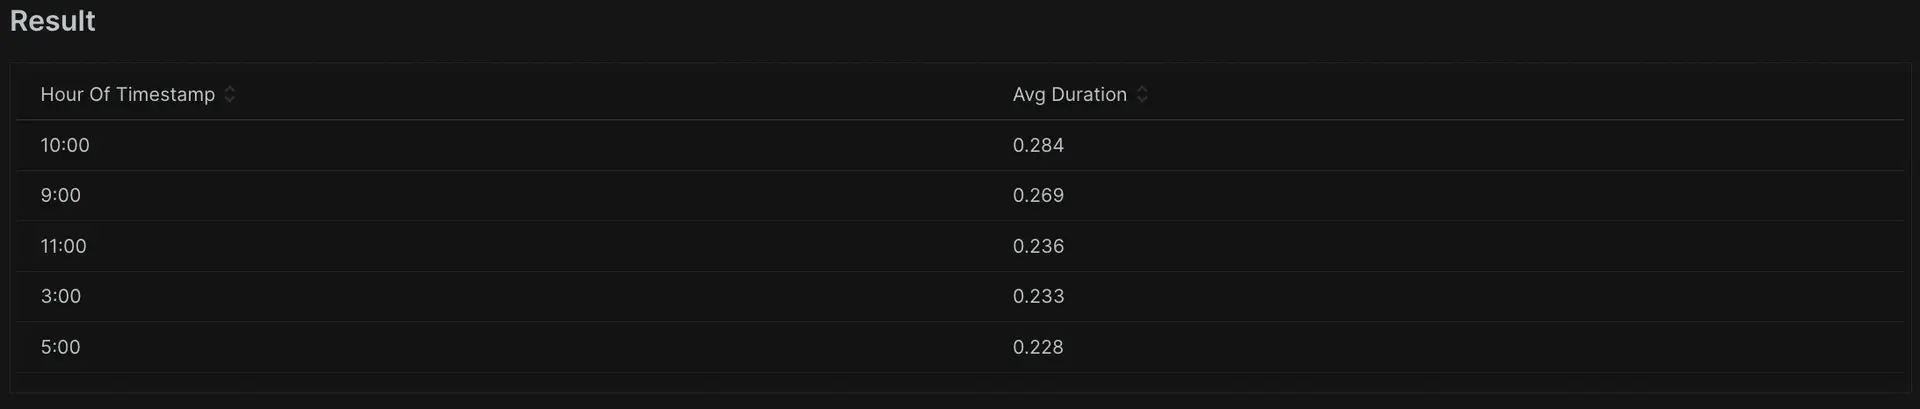
Après avoir exécuté la requête ci-dessus, vous pouvez voir le temps de réponse le plus lent en fonction de l’heure de la journée. New Relic fournit de nombreuses options différentes pour créer des facettes en fonction du temps. L’exemple précédent regroupe par heure, mais vous pouvez également regrouper par jour de la semaine pour déterminer quels jours ont les meilleurs et les pires temps de réponse.
SELECT average(duration) FROM Public_APICall FACET weekdayOf(timestamp) SINCE 1 week ago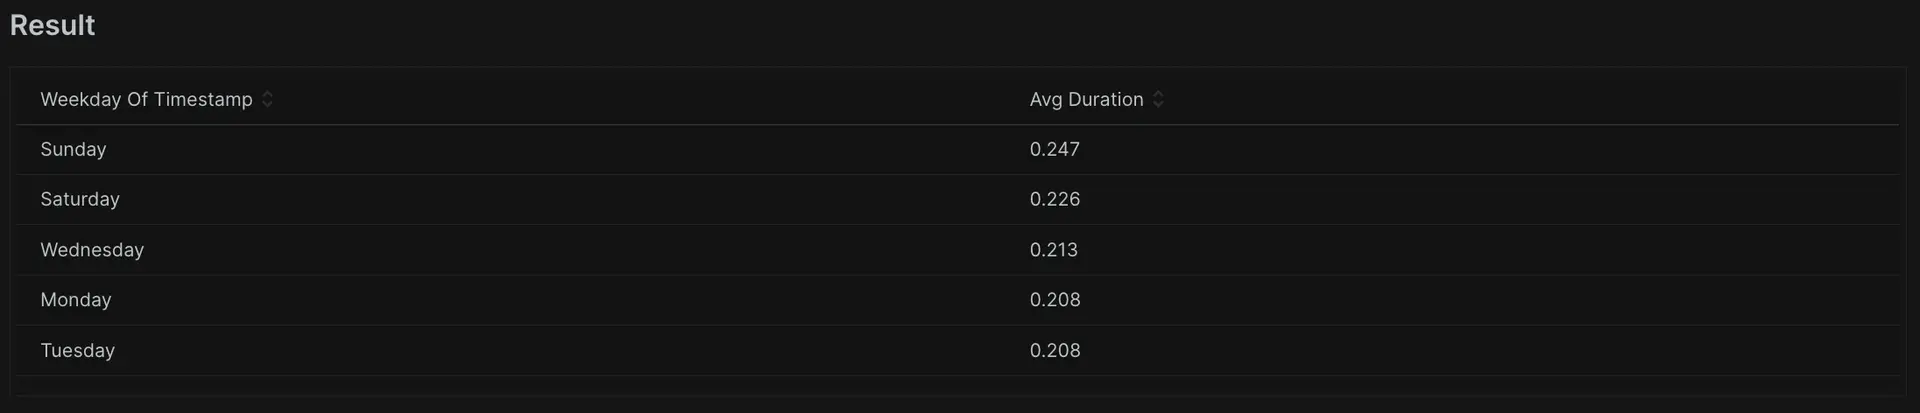
Vous pouvez désormais voir les périodes les plus lentes de vos applications à un jour précis. Vous pouvez l'utiliser pour répondre à des questions essentielles pour l'entreprise, telles que « Quand vendons-nous le plus de produits ? », ou "Quand avons-nous le plus d'inscriptions ou de connexions ?".
Vous pouvez également regrouper les résultats par une date spécifique. Cela est utile lors de l'examen des rapports SLA ou de l'analyse des changements de performances sur une période donnée.
SELECT average(duration) FROM Public_APICall FACET dateOf(timestamp) SINCE 1 week ago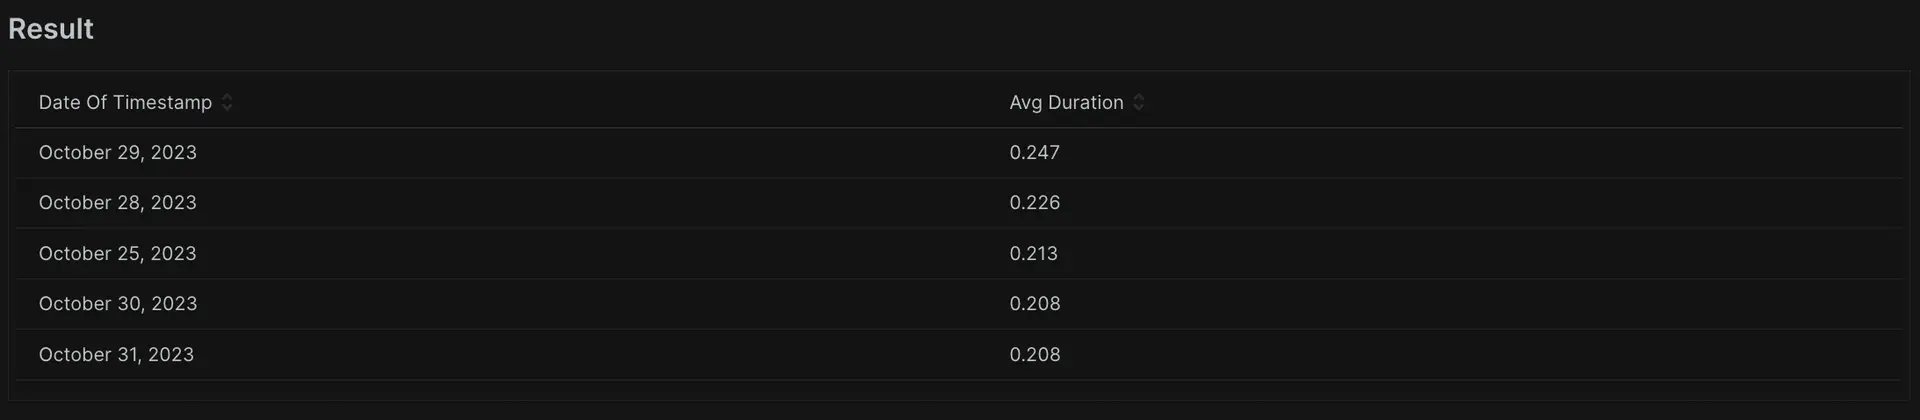
La création de cohortes temporelles expose les problèmes qui surviennent à des minutes, heures, jours ou semaines spécifiques. Quelles que soient les données que vous envoyez à New Relic, NRQL vous permet de découper, analyser, organiser et visualiser vos données dans n’importe quel format dont vous avez besoin.
Il existe également de nombreuses autres options disponibles pour le regroupement, notamment la semaine, le mois, et l’année en fonction de votre rétention des données. Pour voir la liste complète, consultez notre page de documentation Group Results Across Time.
Prochaines étapes
Avec les connaissances que vous avez acquises ici, vous pouvez créer des visualisations de dashboard, et contrôler les aspects de vos données qui vous intéressent le plus. Vous pouvez utiliser ces techniques pour affiner l’analyse pour des alertes plus granulaires, spécifiques, et produire des visualisations plus détaillées. Lorsque vous êtes prêt, vous pouvez passer à notre troisième tutoriel, où vous apprendrez des compétences NRQL supplémentaires, notamment les filtres, les cas de facette, l’histogramme, l’apdex, le filtrage sur les eventTypes, le remplacement des valeurs, et l’extrapolation.