No primeiro tutorial de NRQL, exploramos os fundamentos da criação de consultas. Abordamos a estrutura básica da consulta, a definição de janelas de tempo e como selecionar atributos específicos para observar. Também aprendemos como começar a agregar e exibir dados usando gráficos e outras visualizações.
Neste tutorial, iremos um pouco mais fundo e exploraremos mais funções para criar agregações úteis. Aqui, você aprenderá como comparar os dados retornados com períodos anteriores e agrupar dados em janelas de tempo específicas. Você também encontrará ainda mais coisas para fazer com as funcionalidades SINCE e UNTIL e explorará o uso de curingas em filtros. Especificamente, você aprenderá como:
- consulta de valor exclusivo usando
uniques(attributeName) - Determine quantos valores exclusivos existem em um atributo usando
uniqueCount(attributeName) - Recuperar
earliest(attributeName)elatest(attributeName)dentro de um intervalo de tempo específico - Calcule porcentagens com base em um qualificador ou outro ponto de dados com
percentile() - Execute matemática básica usando funções de atributo e agregação, ou uma combinação de ambas
- Transforme nomes de atributos em algo personalizado e mais legível
- Pesquise para incluir/excluir usando curingas com
LIKEouNOT LIKE, ou limite os resultados àquelesINuma lista ouNOT INessa lista - consulta em janelas de tempo mais avançadas usando datas, época e
WITH TIMEZONE - Agrupe dados em janelas de tempo usando coorte baseada em tempo
Vamos começar!
Funções agregadas
Após concluir o primeiro tutorial de NRQL, você usou count(), average(), sum(), max() e min() para transformar seus dados de maneiras significativas. Mas e se você quiser encontrar e contar valores exclusivos? Para encontrar o número de valores exclusivos registrados para um atributo em um intervalo de tempo especificado, você pode usar a função uniqueCount(). Você só precisa fornecer o atributo que queremos inspecionar como um argumento. Por exemplo, aqui está uma consulta para exibir todas as chamadas de API públicas exclusivas:
SELECT uniqueCount(http.url) FROM Public_APICall SINCE 1 day ago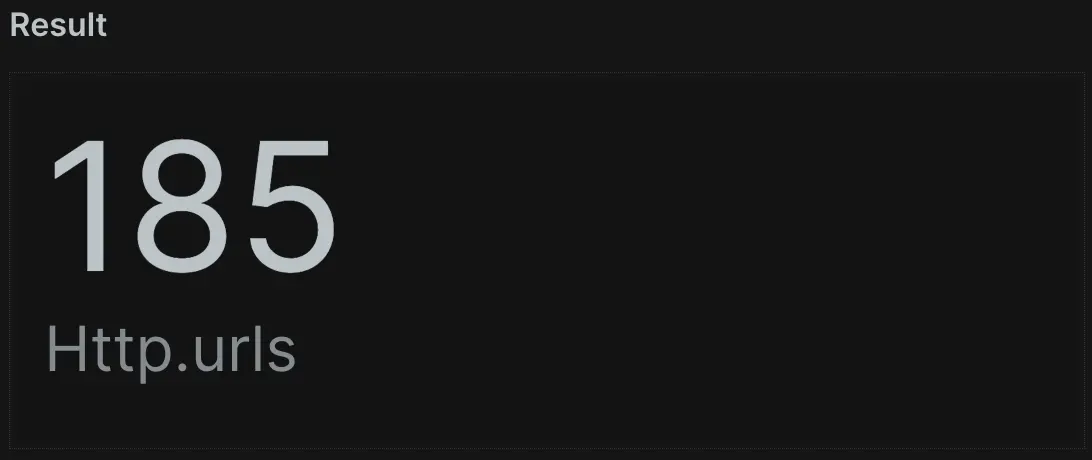
Para otimizar o desempenho da consulta, a função acima retorna resultados aproximados para consultas que fiscalizam mais de 256 valores exclusivos. Para retornar a lista real de valores exclusivos de um atributo em um intervalo de tempo especificado, podemos usar a função uniques() .
SELECT uniques(http.url) FROM Public_APICall SINCE 1 day agoPara especificar um valor limite diferente do padrão de 1.000, use uniques(attribute[,limit]), que aceita um máximo de 10.000.
Para recuperar o valor mais recente de um atributo em um intervalo de tempo especificado, use a função latest() . Neste exemplo de consulta, você pode localizar o tempo de resposta mais recente para uma chamada de API no último dia. Isso pode ajudá-lo a localizar o valor mais recente para uma transação ou serviço de relatório intermitente.
SELECT latest(duration) FROM Public_APICall WHERE awsAPI = 'sqs' SINCE 1 day ago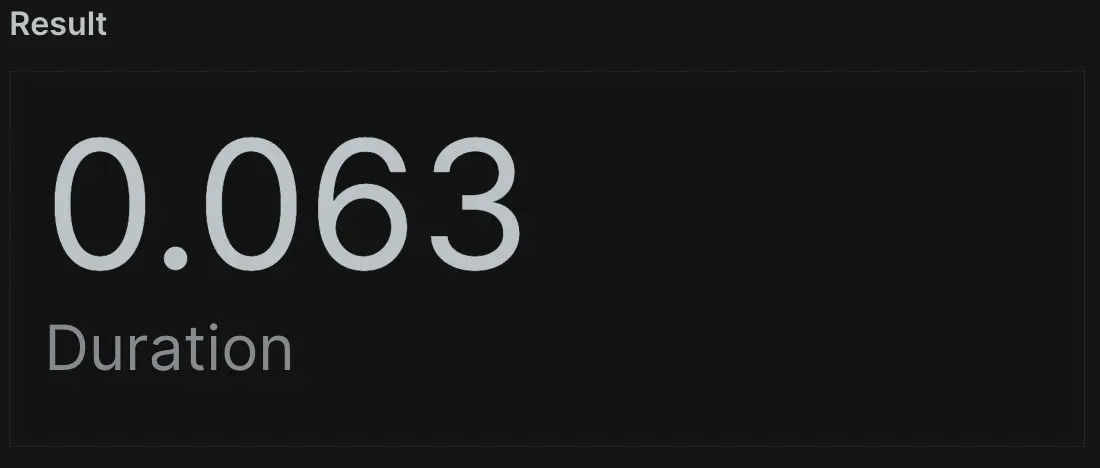
Do outro lado do espectro, você poderia usar a função earliest() para conseguir o oposto. Ele retornará o valor mais antigo de um atributo registrado no intervalo de tempo especificado. Neste exemplo de consulta, você pode recuperar o primeiro tempo de resposta para uma chamada de API no último dia. Se os dados forem relatados de forma consistente, isso reportará o ponto de dados do primeiro evento nas últimas 24 horas.
SELECT earliest(duration) FROM Public_APICall WHERE awsAPI = 'sqs' SINCE 1 day ago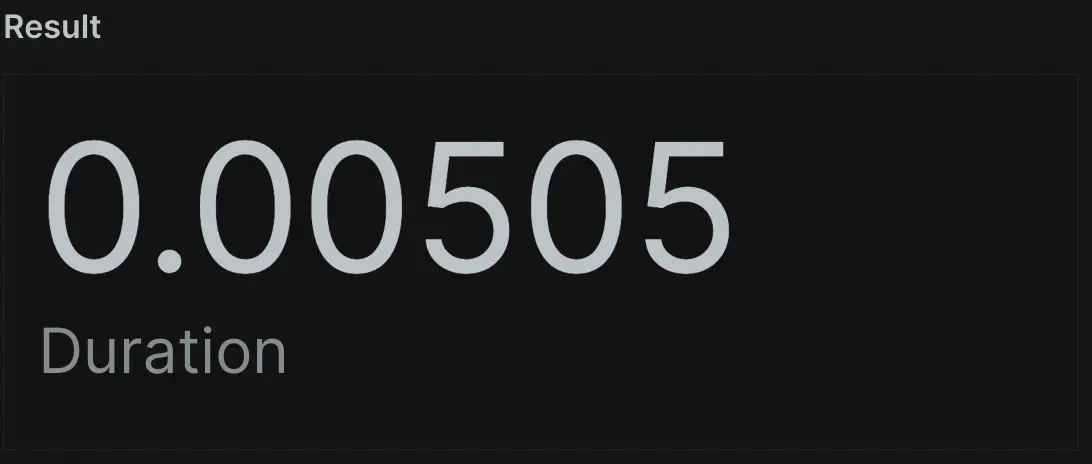
Pode ser necessário usar porcentagens em vez de contagens, somas ou médias. O uso da função percentage() permite calcular a porcentagem de um valor no conjunto de dados que corresponde a uma condição especificada. Essa função aceita dois argumentos: o primeiro é uma função de agregador para o atributo desejado, como count(). O segundo é uma condição WHERE para especificar o subconjunto de dados a ser consultado.
Neste exemplo de consulta, você pode encontrar a porcentagem de chamadas de API no último dia que tiveram uma duração (ou tempo de resposta) superior a 100 milissegundos.
SELECT percentage(count(*), WHERE duration > 0.1) FROM Public_APICall SINCE 1 day ago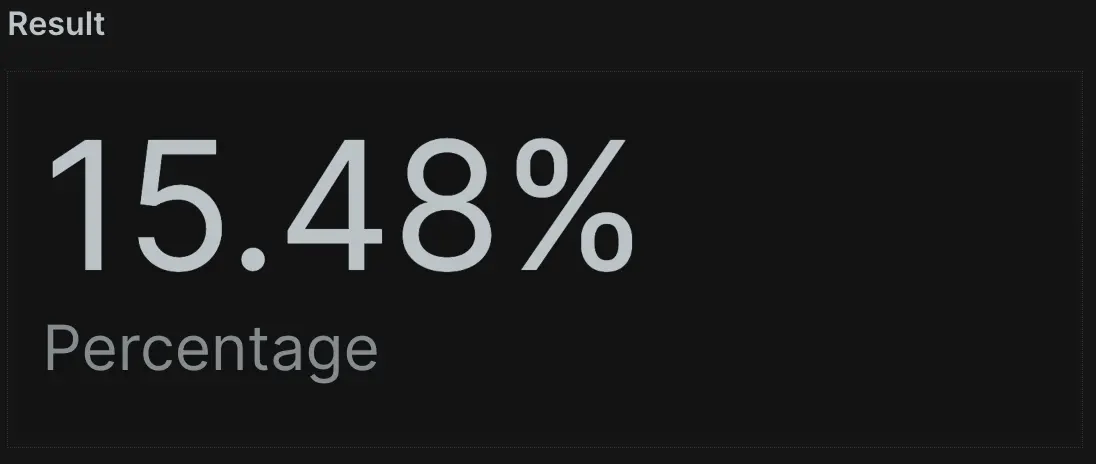
É muito comum visualizar dados de desempenho do aplicativo ou de experiência dos clientes usando percentis em vez de médias. Você pode usar a função percentile() para entender a experiência do enésimo percentil.
Por exemplo, digamos que você queira saber qual foi a pior experiência (maior duração) de 98% dos seus clientes no último dia. Você pode solicitar ao NRDB percentile(duration, 98) das últimas 24 horas.
SELECT percentile(duration,98) FROM Public_APICall SINCE 1 day ago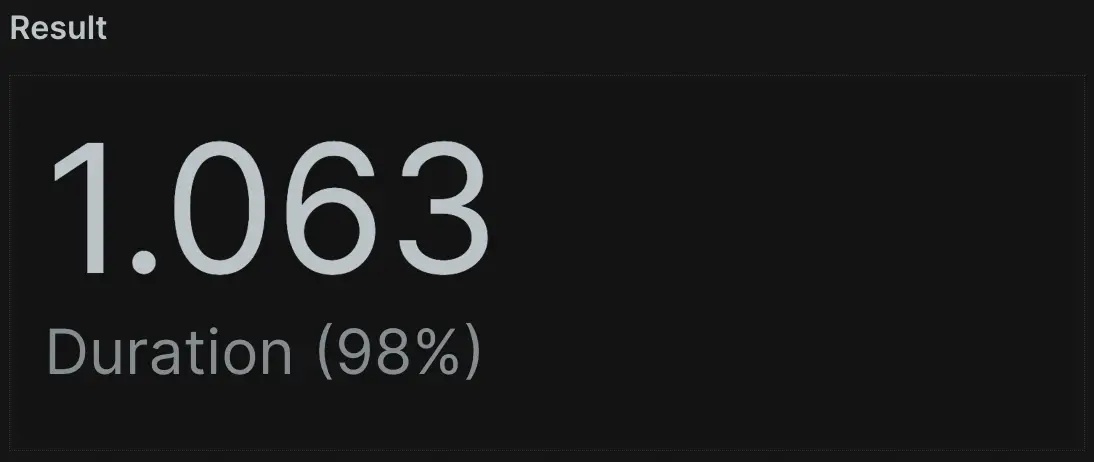
Como você pode ver, a agregação oferece controle flexível sobre seus dados. Você pode usar uniqueCount() para contar as entradas exclusivas de um atributo específico. Mas também é possível usar isso para identificar uma contagem de máquinas exclusivas, contêineres de relatórios ou até mesmo quantos pontos de dados personalizados são enviados para a New Relic. E, se quiser saber quais valores exclusivos estão disponíveis para consulta, sempre é possível solicitar uma lista usando uniques().
As funções latest() e earliest() têm um valor particular ao lidar com dados esparsos ou ao investigar quando algo começou ou parou de relatar (presumindo que o New Relic ainda armazene os dados). A função percentage() pode mostrar qual porcentagem de eventos correspondeu a um qualificador em comparação com o conjunto de resultados geral. Por fim, você pode usar percentile() como um principal indicador de desempenho definindo uma meta para garantir que 90% de todas as transações do usuário final excedam a duração fornecida.
Na próxima etapa, você aprenderá como fazer matemática básica com NRQL.
Use operadores matemáticos
O NRQL oferece suporte a operadores matemáticos básicos. Você pode realizar adição (+), subtração (-), multiplicação (*) e divisão (/) tanto em valores de atributo numéricos quanto em resultados de funções de agregador.
Por exemplo, capturamos tanto o tempo de resposta total (como duration) quanto o tempo de resposta do banco de dados (como databaseDuration) quando registramos um evento de transação. Mas e se você quiser encontrar o tempo médio gasto fora do processamento do banco de dados? Você pode começar calculando esse valor para cada evento em seu conjunto de dados usando uma consulta como esta.
SELECT GigabytesIngestedBillable - GigabytesIngestedFree, metric FROM NrMTDConsumption WHERE productLine IS NOT NULLÓtimo! Você acabou de realizar algumas operações matemáticas básicas. Isso é útil para ajudar você a listar eventos individuais. Mas e se você quiser saber a duração média das transações sem o tempo do banco de dados? Você também pode fazer a aritmética dentro da função:
SELECT average(GigabytesIngestedBillable - GigabytesIngestedFree) FROM NrMTDConsumption WHERE GigabytesIngestedBillable IS NOT NULLAgora, e se você quisesse complicar ainda mais subtraindo, dividindo e multiplicando na mesma consulta para descobrir a duração sem o tempo do banco de dados, como uma porcentagem do tempo total? Bem, você pode adicionar a matemática:
SELECT average(GigabytesIngestedBillable - GigabytesIngestedFree) / unitPrice * 100 FROM NrMTDConsumption WHERE GigabytesIngestedBillable IS NOT NULLO New Relic relata tempos como parte de seus eventos, para que você possa usá-los para calcular pontos de dados ou até mesmo gerar resultados percentuais. Você pode estender isso ainda mais aplicando esses operadores matemáticos a ações ou eventos personalizados, ou a dados personalizados que você envia para o New Relic. Por exemplo, uma plataforma de comércio eletrônico que relata dados sobre tamanhos de pedidos e métodos de pagamento pode usar matemática para calcular coisas como a taxa de conversão de pedidos em relação a visitas exclusivas de clientes.
Na próxima etapa, você aprenderá como usar o NRQL para rotular seu atributo.
Atributo da etiqueta
À medida que você começa a executar funções NRQL mais complexas, pode se perguntar se é possível tornar os nomes exibidos para os atributos de consulta mais úteis, especialmente para outras pessoas que não conhecem o NRQL. Vamos considerar um exemplo usando o que você aprendeu no tutorial anterior.
SELECT average(duration-externalDuration) FROM TransactionVocê pode usar a cláusula AS após uma função ou atributo para dar ao resultado um nome mais legível e significativo. Isso ajuda você e sua equipe a entender exatamente o que um gráfico representa.
SELECT average(duration-externalDuration) AS 'Non-External Response Time' FROM TransactionIsso pode parecer meramente estético, mas ao criar dashboards detalhados, é importante rotular claramente seus dados. Isso torna a fonte de dados clara para qualquer pessoa que visualize seus widgets, billboards, gráficos de linha ou tabelas.
Voltaremos a isso em uma próxima lição sobre agrupamento, para explorar como AS também pode criar conjuntos de resultados limpos em cenários mais avançados. A seguir, você aprenderá como comparar dados em diferentes janelas de tempo.
Comparar janelas de tempo
Agora você já pratica o uso de intervalos de tempo com cláusulas SINCE e UNTIL . Mas e se você quiser comparar valores de diferentes intervalos de tempo? Você pode conseguir isso com a cláusula COMPARE WITH .
NRQL usa SINCE e UNTIL para definir um período de interesse. Em seguida, você pode indicar o período de tempo com o qual deseja comparar usando uma cláusula COMPARE WITH [time period] AGO contendo um valor de deslocamento relativo.
Por exemplo, no exemplo de consulta abaixo, você pode comparar os dados do último dia com os dados da semana anterior usando um deslocamento relativo de 1 semana atrás.
SELECT average(duration) FROM Public_APICall SINCE 1 day ago COMPARE WITH 1 week ago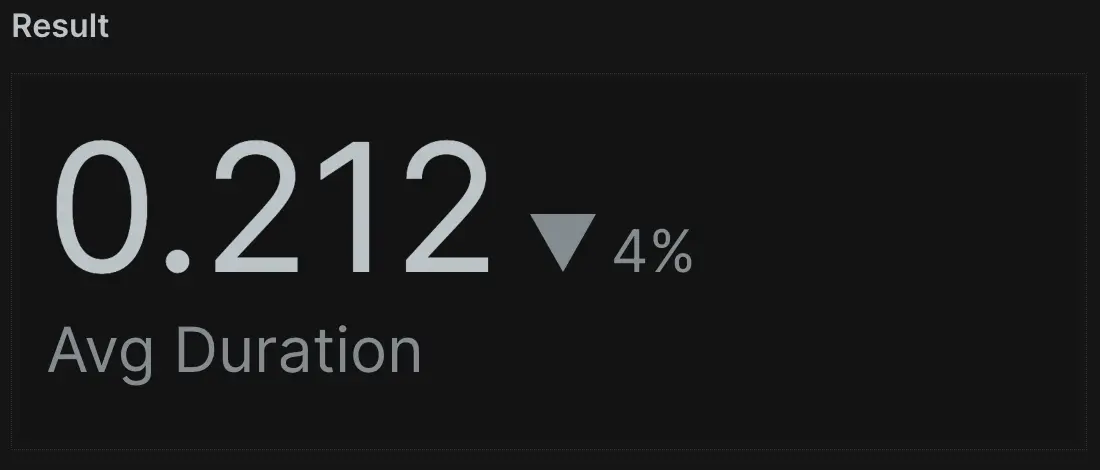
Para mapear a comparação de valores ao longo do tempo, adicione TIMESERIES. Isso cria um gráfico de linhas de comparação, permitindo visualizar como esse período se compara aos dados recentes e acompanhá-lo ao longo do tempo.
SELECT average(duration) FROM Public_APICall SINCE 1 day ago COMPARE WITH 1 week ago TIMESERIES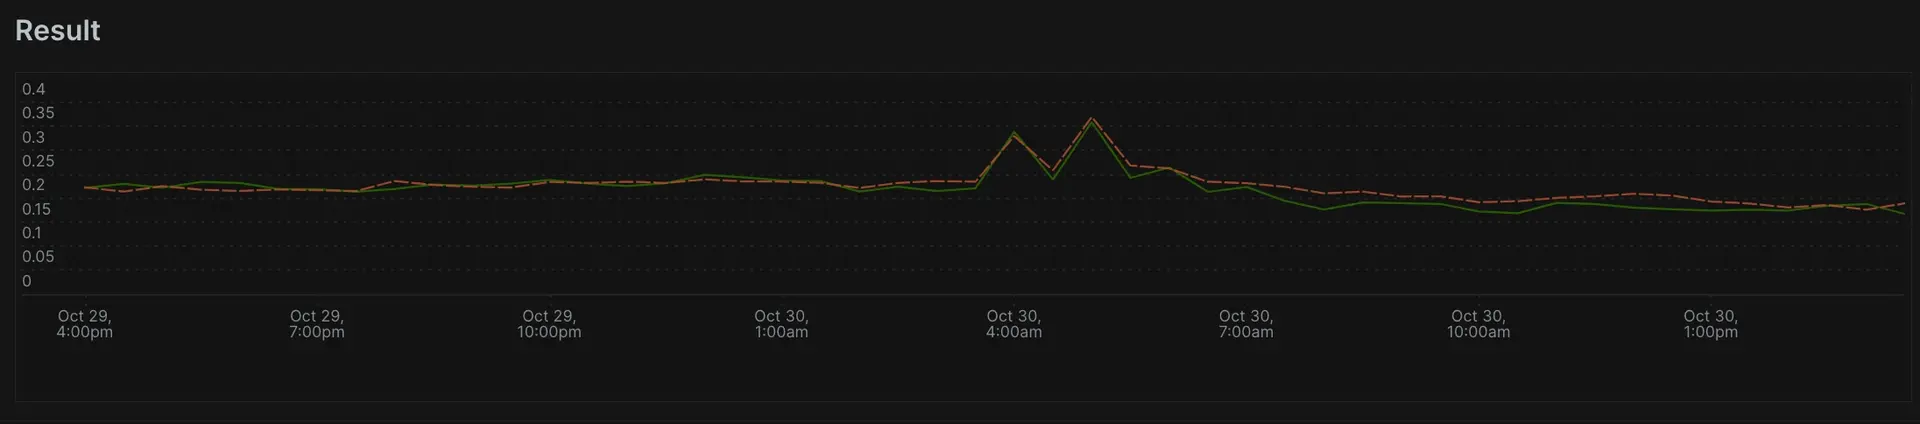
Você também pode especificar vários períodos de tempo relativos diferentes no mesmo formato, semelhante a UNTIL. Para instância, você pode especificar 4 WEEKS AGO ou 6 HOURS AGO.
SELECT average(duration) FROM Public_APICall SINCE 1 hour ago COMPARE WITH 6 hours ago TIMESERIESAs comparações podem responder rapidamente a perguntas sobre o que está acontecendo em seus aplicativos. Os diferentes valores de vendas, desempenho, MTTR ou erros estão maiores ou menores em comparação com a semana passada? E, se você estiver investigando um problema, achará útil comparar um período de desempenho problemático com um período de desempenho normal.
Use filtros curinga
Agora você sabe usar uma cláusula WHERE para filtrar os resultados em nossa consulta. Além de usar operadores de comparação padrão, você também pode usar LIKE e NOT LIKE se quiser descobrir se um atributo contém ou não uma substring especificada. Para conseguir isso, você pode usar o símbolo de porcentagem (%) como curinga em qualquer lugar da string.
Em nossa consulta de amostra, você pode obter o número de transações com o termo "amazonaws" em qualquer lugar (início, meio ou fim) do nome.
SELECT count(*) FROM Public_APICall WHERE http.url LIKE '%amazonaws%' FACET http.url SINCE 1 day ago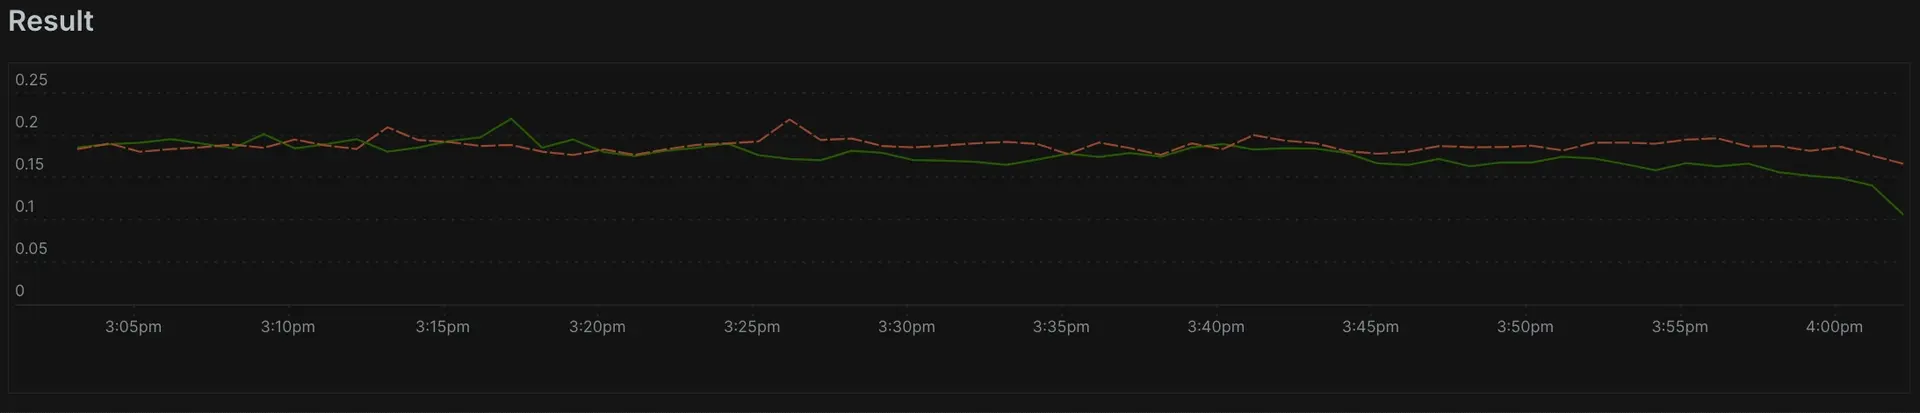
Se você alterar sua consulta para usar NOT LIKE , obterá o número de transações que não contêm a palavra escolhida (como "google", conforme abaixo) em seu nome.
SELECT count(*) FROM Public_APICall WHERE http.url NOT LIKE '%google%' FACET http.url SINCE 1 day ago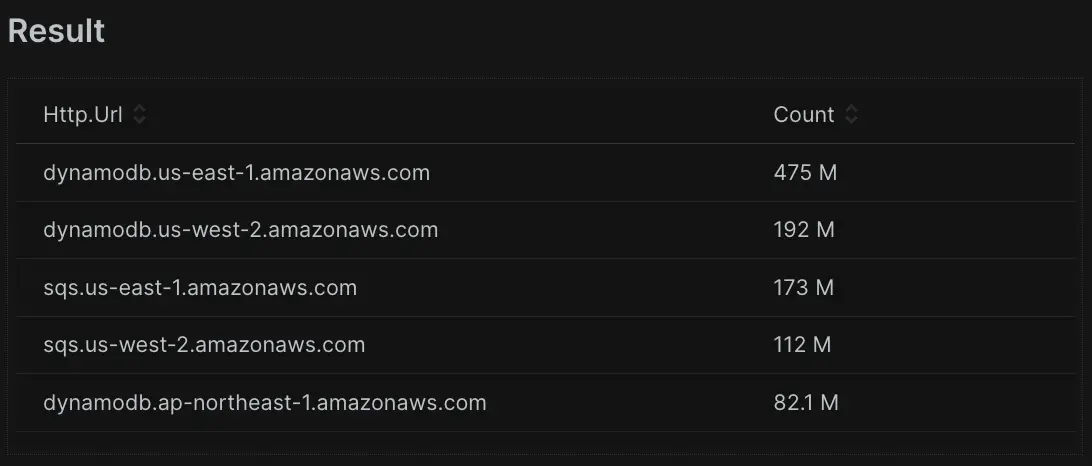
Você pode usar % como um curinga no início e no fim, o que significa que a New Relic verifica se o valor do atributo que você escolheu contém o termo, como “Web” em qualquer lugar do texto. Da mesma forma, você pode usar %Web OU Web% para corresponder a algo que termina com “Web” ou começa com “Web”, respectivamente.
Você também pode adicionar o curinga entre as strings para uma pesquisa mais refinada. Esta consulta verifica um nome de transação que contém a palavra "amazon" seguida de qualquer texto, mas também contém o termo ".com" seguido por qualquer número de caracteres. Assim, os resultados só serão negociados com “amazon” e “.com” no nome.
SELECT count(*) FROM Public_APICall WHERE http.url NOT LIKE '%amazon%.com' FACET http.url SINCE 1 day ago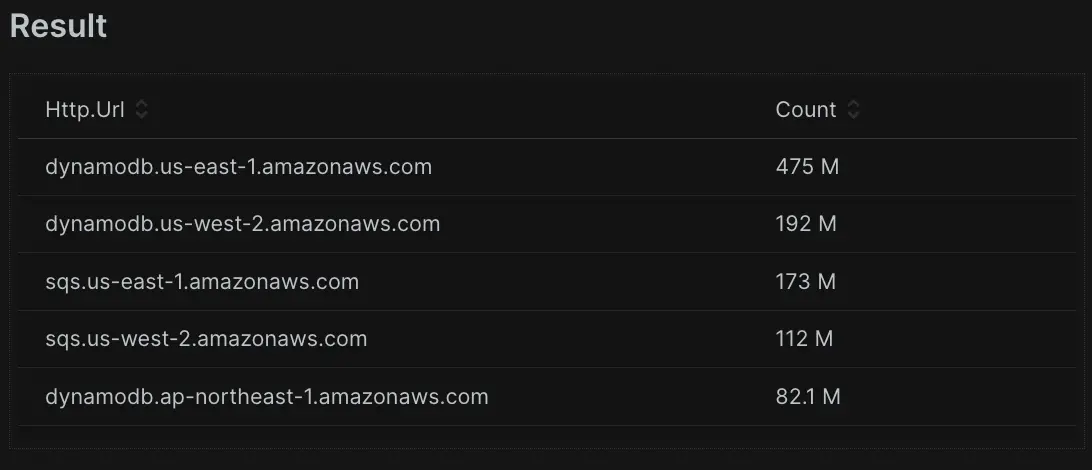
E se você precisar de extrema especificidade e os nomes não tiverem uma string comum que possa corresponder usando curingas? Os operadores IN e NOT IN permitem especificar um conjunto de valores que você gostaria de verificar em um atributo. Em vez de especificar diversas cláusulas WHERE com operadores AND ou OR , você pode simplificar uma condição listando os valores entre parênteses separados por vírgulas.
Neste exemplo de consulta, você pode contar o número de transações cujo subtipo é "graph.microsoft.com" ou "s3.amazonaws.com". Se você alterar a consulta para usar NOT IN , obterá o número de transações cujo subtipo não é "graph.microsoft.com" nem "s3.amazonaws.com".
SELECT count(*) FROM Public_APICall WHERE http.url IN ('graph.microsoft.com', 's3.amazonaws.com') SINCE 1 day ago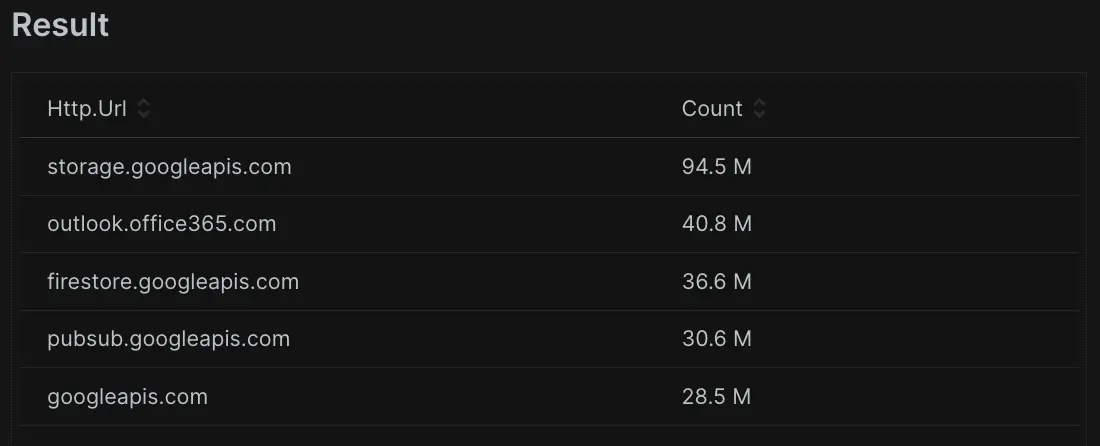
Agora você pode controlar seus dados e manipulá-los para fazer o que precisa, permitindo construir dashboards e alertas. A seguir, você aprenderá como especificar intervalos de tempo usando NRQL.
Especifique intervalos de tempo
As cláusulas SINCE e UNTIL fazem mais do que fornecer informações sobre intervalos de tempo relativos: você também pode fornecer a elas uma data ou hora específica. Na seguinte consulta de exemplo, você pode usar uma data SINCE no formato YYYY-MM-DD.
SELECT average(duration) FROM Public_APICall SINCE '2023-10-28' TIMESERIES MAX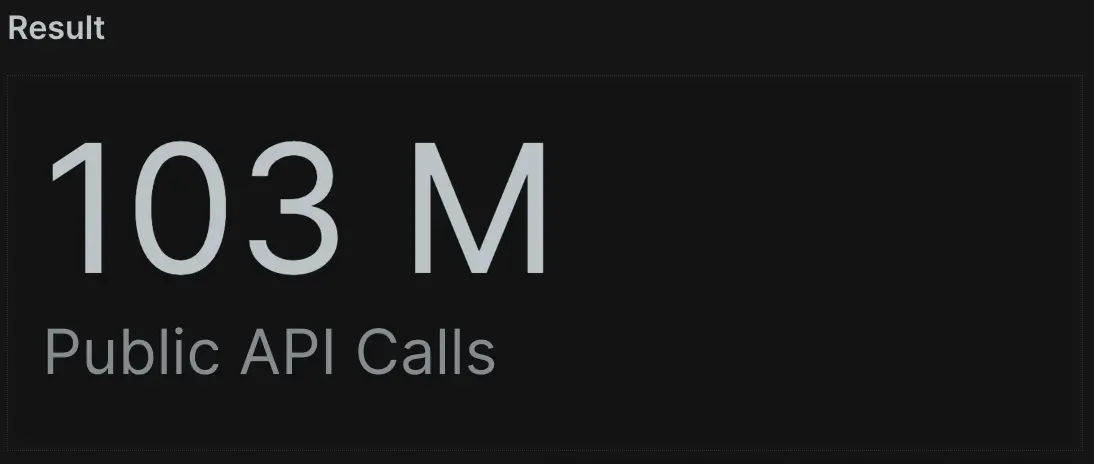
Você pode usar isso para criar relatórios de SLA para um período de tempo especificado. Você pode até incluir uma hora específica com o formato YYYY-MM-DD HH:MM. Nesta consulta, você pode ver que os dados estão definidos para as 18h.
SELECT average(duration) FROM Public_APICall SINCE '2023-10-28 18:00' TIMESERIES MAX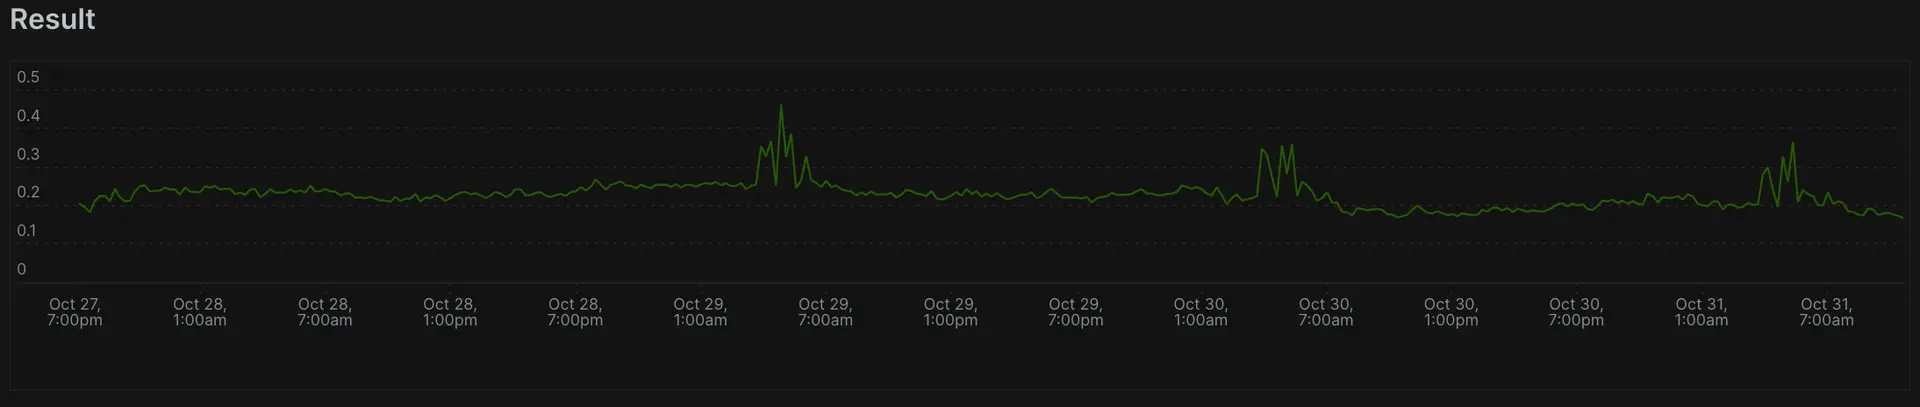
Às vezes, você pode receber um tempo de evento no tempo epoch (unix). Você também pode usar timestamps epoch com as cláusulas SINCE e UNTIL para não precisar traduzir manualmente esses valores para outro formato de data.
SELECT average(duration) FROM Public_APICall SINCE 1698525489519 UNTIL 1698698289519 TIMESERIES MAX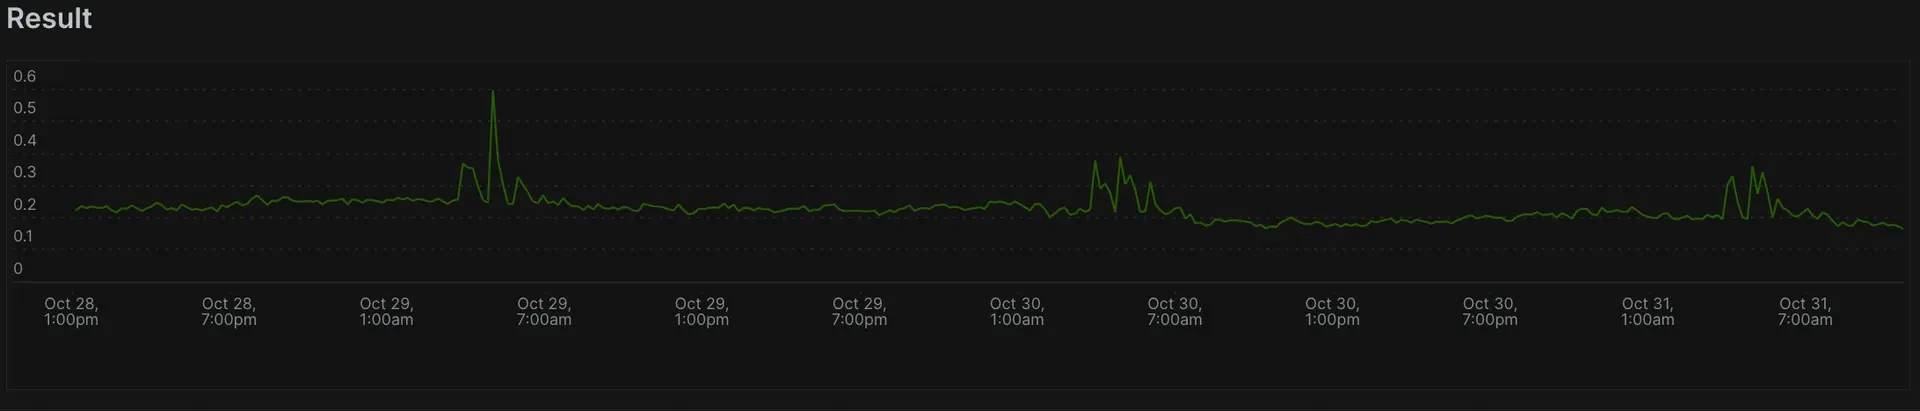
Quando o NRDB mostra dados durante um período de tempo, ele pressupõe que você deseja ver os dados da perspectiva do seu fuso horário. Mas com equipes internacionais dispersas, o seu hoje pode ser o de um companheiro de equipe amanhã ou ontem, dependendo da localização. Você pode usar a cláusula WITH TIMEZONE para definir um fuso horário do qual exibir dados. Isso afeta a interpretação dos valores nas cláusulas SINCE e UNTIL .
Considere os dois gráficos de exemplo abaixo. Cada consulta tem um fuso horário especificado usando WITH TIMEZONE. Os dois estão separados por 8 horas. Observe que o padrão de dados é o mesmo, mas com deslocamento de 8 horas para alinhar com cada fuso horário respectivo:
SELECT count(*) FROM Public_APICall SINCE yesterday UNTIL today WITH TIMEZONE 'America/Los_Angeles' TIMESERIES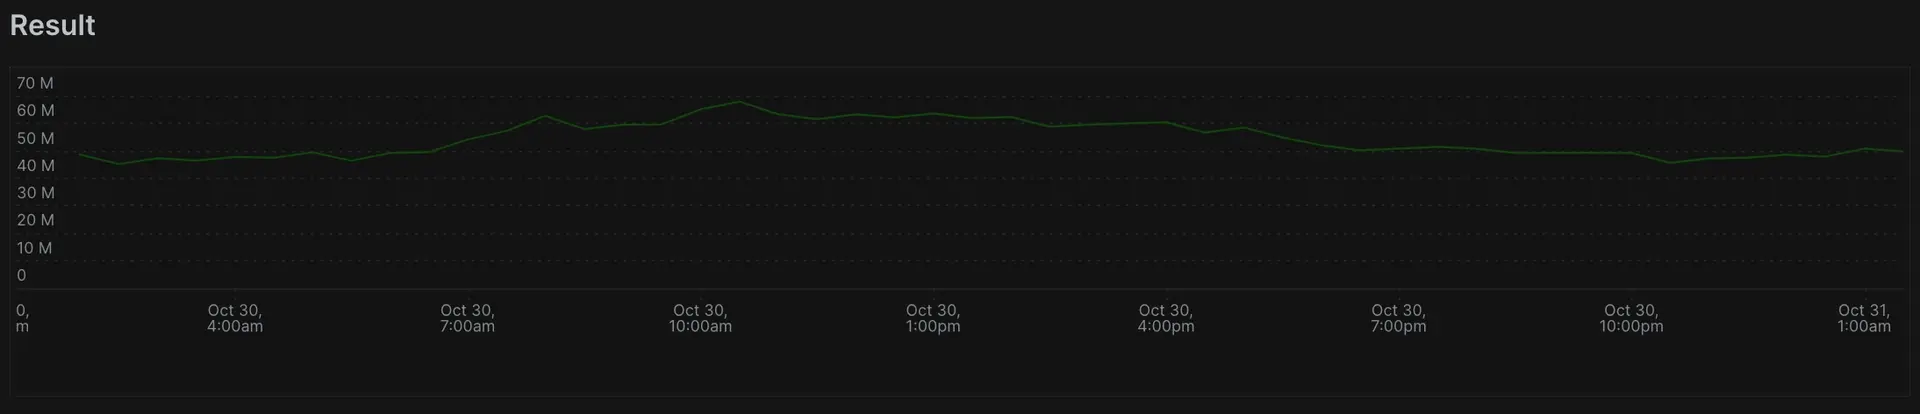
SELECT count(*) FROM Public_APICall SINCE yesterday UNTIL today WITH TIMEZONE 'Europe/London' TIMESERIES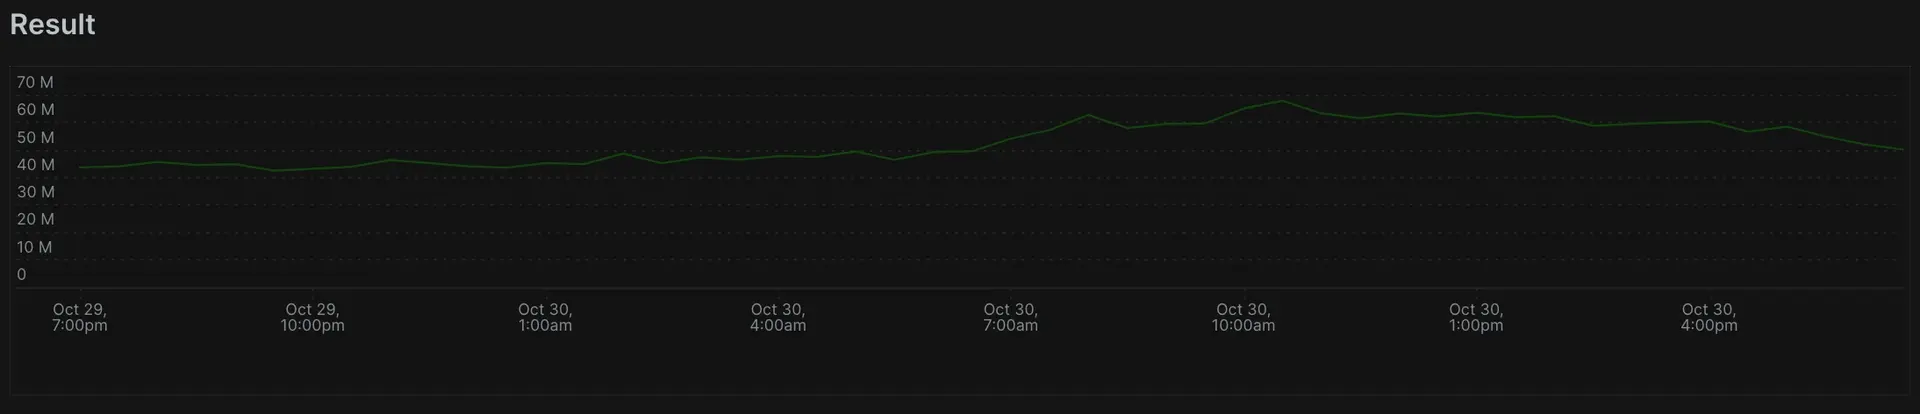
Antes desta lição, todos os seus mecanismos de controle de tempo dependiam de tempos relativos a partir de agora. Agora, você pode ajustar a visualização dependendo da localização de alguém no mundo. Talvez um cliente na Costa Leste relate um problema para sua equipe de engenharia localizada na Costa Oeste. Sua equipe pode criar um dashboard e traduzir a visualização para mapear para o fuso horário que um cliente citaria. Portanto, se um cliente relatar um problema às 9h na Costa Leste, você pode garantir que, ao olhar para as 9h, não precisará traduzir mentalmente a diferença.
Quando você precisa focar em datas específicas de um evento de alerta e deseja investigar os dados sem uma janela de tempo móvel relativa ao horário atual, isso ajudará você a obter dados em uma janela de tempo estática. Na próxima e última lição, você continuará aprendendo a usar o tempo em seus relatórios com coortes baseadas no tempo.
Use coorte baseada em tempo
Embora possa parecer complexo, a coorte baseada no tempo significa apenas uma maneira de organizar os dados em grupos baseados no tempo, como minuteOf, hourOf, weekOf e muito mais.
Quando você usa a cláusula SINCE para durações, você recupera toda a extensão de tempo da consulta. Mas esses dados podem nem sempre contar toda a história! E se você precisar analisar o desempenho dentro de um período de tempo mais de perto? Com coortes baseadas no tempo, você pode classificar ainda mais os dados em agrupamentos lógicos baseados no tempo.
Usando uma combinação de FACET e uma das muitas funções baseadas em tempo (como hourOf(timestamp)), você pode obter dados de uma semana e entender o desempenho com base na hora específica em que ocorreu. Isso revela tendências e identifica os momentos mais críticos para o seu aplicativo:
SELECT average(duration) FROM Public_APICall FACET hourOf(timestamp) SINCE 1 week ago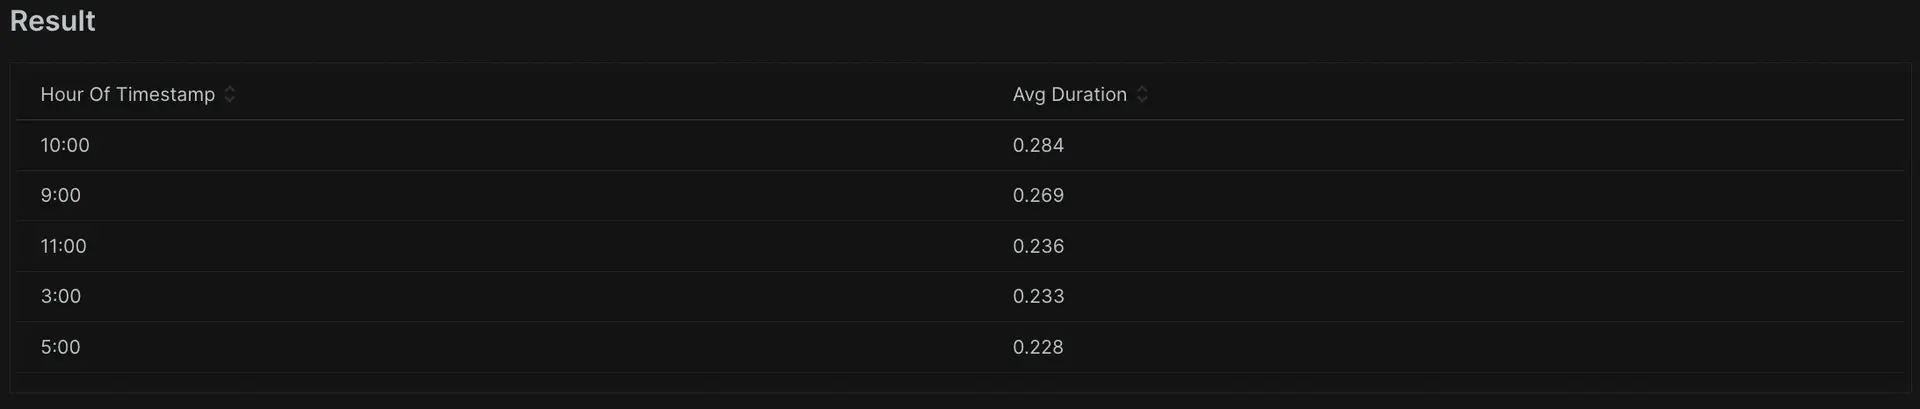
Depois de executar a consulta acima, você pode ver o tempo de resposta mais lento com base na hora do dia. A New Relic oferece muitas opções diferentes para facetar com base no tempo. O exemplo anterior agrupa por hora, mas você também pode agrupar por dia da semana para determinar quais dias têm o melhor e o pior tempo de resposta.
SELECT average(duration) FROM Public_APICall FACET weekdayOf(timestamp) SINCE 1 week ago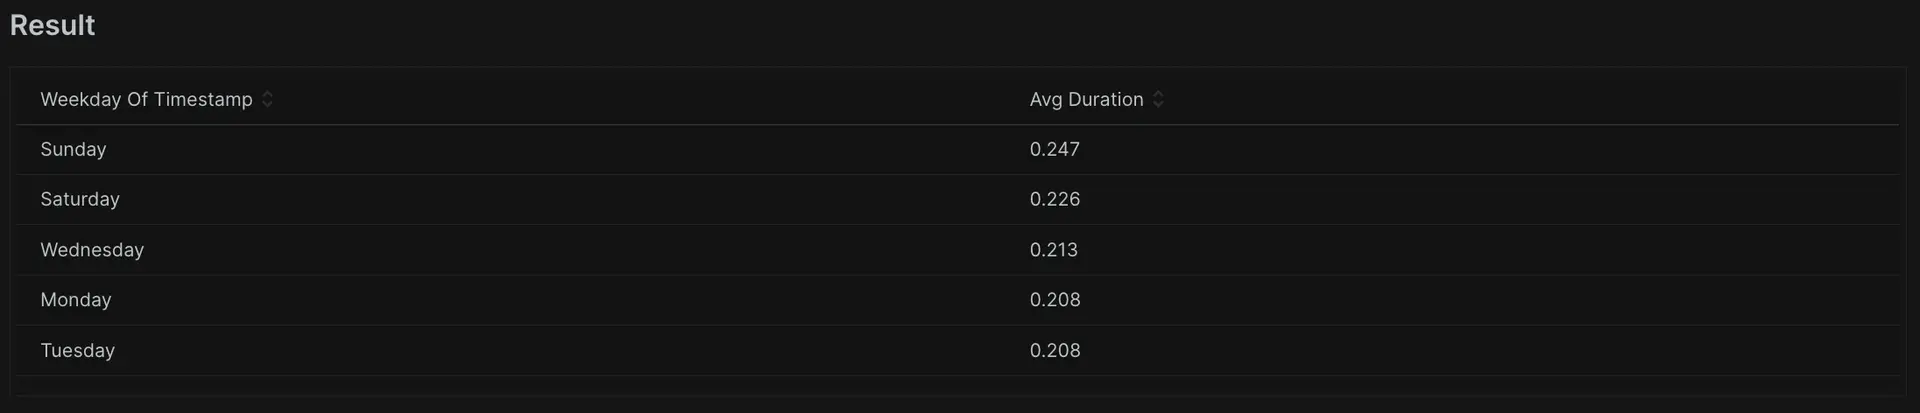
Agora você pode ver os períodos mais lentos do seu aplicativo em qualquer dia específico. Você pode usar isso para responder a perguntas críticas de negócios, como "Quando vendemos mais produtos?", ou "Quando temos mais inscrições ou logins?".
Você também pode agrupar os resultados por uma data específica. Isso ajuda ao considerar relatórios de SLA ou analisar mudanças de desempenho durante um determinado período.
SELECT average(duration) FROM Public_APICall FACET dateOf(timestamp) SINCE 1 week ago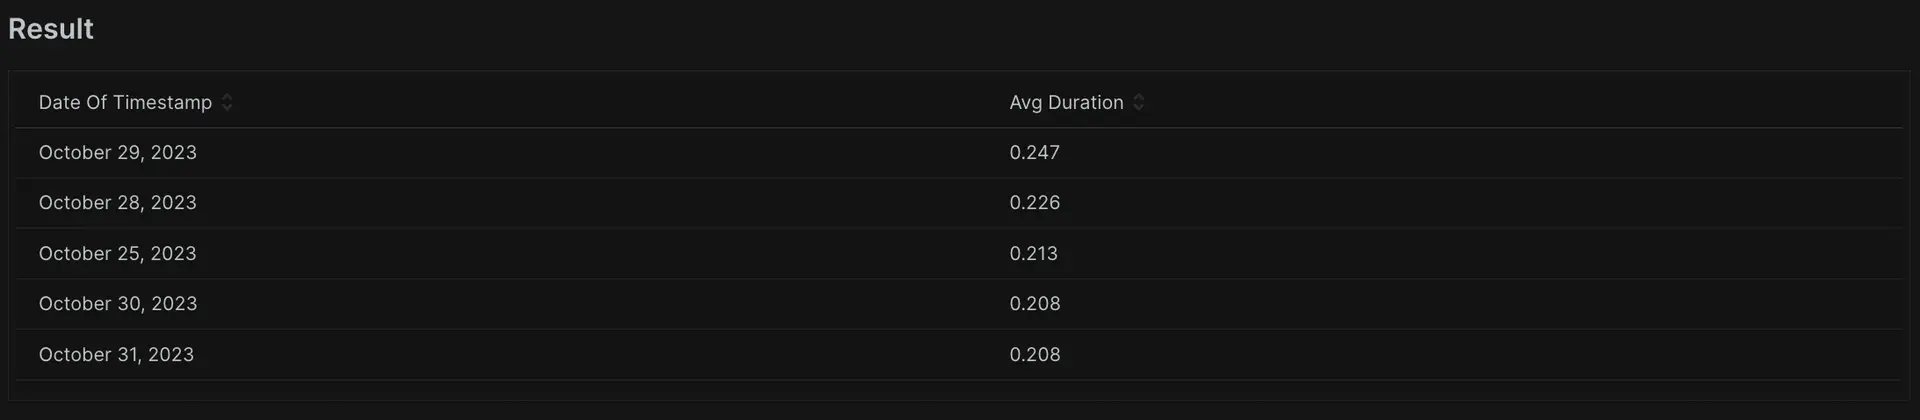
A coorte baseada em tempo expõe problemas que ocorrem em minutos, horas, dias ou semanas específicos. Não importa quais dados você envie para o New Relic, a NRQL permite que você divida, detalhe, organize e visualize seus dados em qualquer formato que precisar.
Há também muitas outras opções disponíveis para agrupar, incluindo semana, mês e ano, dependendo da sua retenção de dados. Para ver a lista completa, acesse nossa página de documentação Group Results Across Time.
Próximos passos
Com o conhecimento adquirido aqui, você pode criar visualizações de dashboard e controlar os aspectos dos seus dados nos quais tem mais interesse. Você pode usar essas técnicas para restringir o foco para alertas mais granulares e específicos e produzir visualizações mais detalhadas. Quando estiver pronto, você pode avançar para o nosso terceiro tutorial, onde aprenderá habilidades adicionais de NRQL, incluindo filtros, casos de faceta, histograma, apdex, filtragem para eventTypes, substituição de valores e extrapolação.