1番目のNRQLチュートリアルでは、クエリ構築の基礎について学習しました。基本的なクエリ構造、タイムウィンドウの定義、および監視する特定の属性を選択する方法について説明しました。また、グラフやその他の視覚化を使用してデータの集計および表示を開始する方法についても学習しました。
このチュートリアルでは、さらに深く掘り下げて、有用な集計を作成するための関数をさらに検討していきます。ここでは、返されたデータを以前の期間と比較し、データを特定の時間枠にグループ化する方法を学習します。また、 SINCEとUNTIL機能をさらに活用したり、フィルタでのワイルドカードの使用について調べたりすることもできます。具体的には、次の方法を学びます。
- を使用して一意の値をクエリします。
uniques(attributeName) - 次を使用して、属性内に存在する一意の値の数を確認します。
uniqueCount(attributeName) - 特定の時間枠内で
earliest(attributeName)とlatest(attributeName)を取得します - 〜を使用して、修飾子またはその他のデータポイントに基づいてパーセンテージを計算します
percentile() - 属性と集計関数、または両方の組み合わせを使用して基本的な計算を実行します。
- 属性名をカスタムで読みやすいものにキャストします
LIKEまたはNOT LIKEを使用してワイルドカードで含める/除外する検索を行うか、結果をリストにINもの、またはそのリストにNOT INものに制限します。- 日付、エポック、および
WITH TIMEZONE - 時間ベースのコホーティングを使用して、データを時間枠にグループ化します
それでは始めましょう。
集計関数
1番目のNRQLチュートリアルを完了した後、count()、average()、sum()、max()、およびmin()を使用して、データを意味のある方法で変換しました。しかし、ユニーク値を見つけてカウントしたい場合はどうすればよいでしょうか?指定された時間範囲内に記録された属性のユニーク値の数を見つけるには、uniqueCount()関数を使用できます。検査したい属性を引数として指定するだけです。例えば、すべてのユニークなパブリックAPIコールを表示するクエリは次のとおりです:
SELECT uniqueCount(http.url) FROM Public_APICall SINCE 1 day ago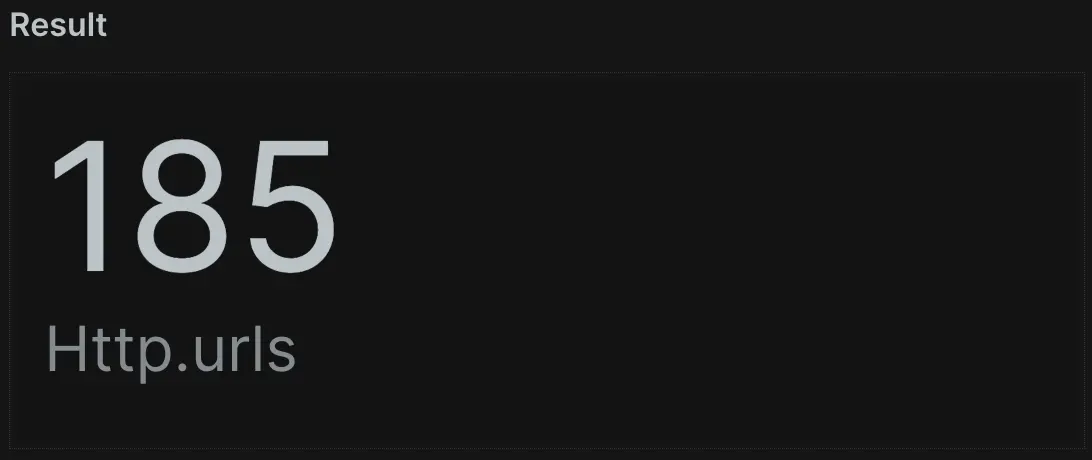
クエリのパフォーマンスを最適化するために、上記の関数は 256 を超える一意の値を検査するクエリのおおよその結果を返します。指定された時間範囲における属性の一意の値の実際のリストを返すには、 uniques()関数を使用できます。
SELECT uniques(http.url) FROM Public_APICall SINCE 1 day agoデフォルトの1,000とは異なる制限値を指定するには、最大10,000まで指定できるuniques(attribute[,limit])を使用します。
指定した時間範囲における属性の最新の値を取得するには、 latest()関数を使用します。このサンプル クエリでは、過去 1 日の API 呼び出しの最新の応答時間を見つけることができます。これは、断続的にレポートされるトランザクションまたはサービスの最新の値を見つけるのに役立ちます。
SELECT latest(duration) FROM Public_APICall WHERE awsAPI = 'sqs' SINCE 1 day ago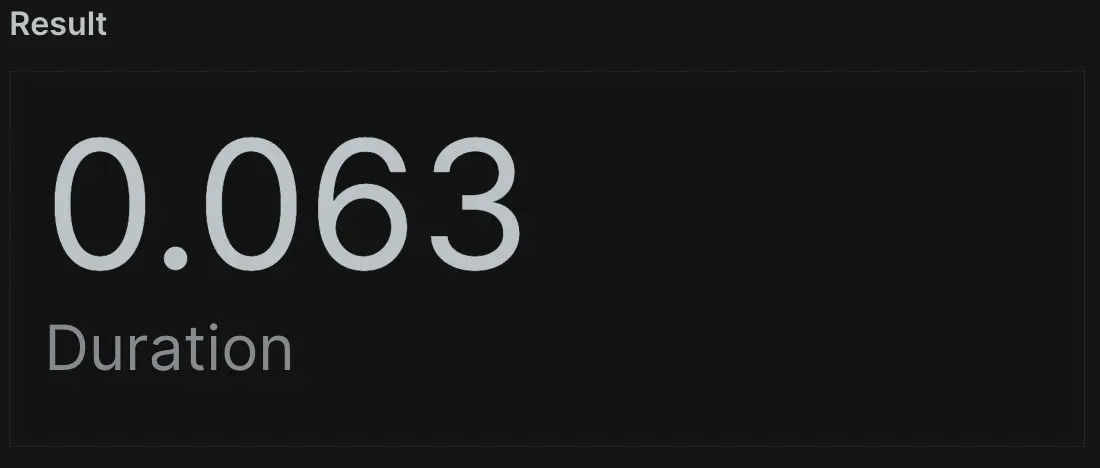
逆に、 earliest()関数を使用すると、その逆のことを実現できます。指定された時間範囲内に記録された属性の最も古い値を返します。このサンプル クエリでは、過去 1 日の API 呼び出しの最も早い応答時間を取得できます。データが一貫してレポートされている場合、過去 24 時間の最も古いイベントのデータ ポイントがレポートされます。
SELECT earliest(duration) FROM Public_APICall WHERE awsAPI = 'sqs' SINCE 1 day ago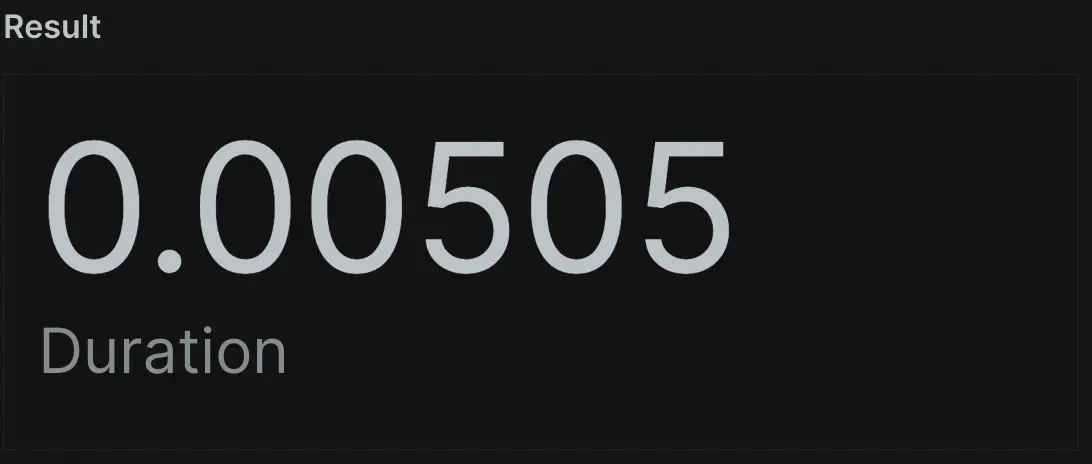
カウント、合計、平均ではなく、パーセンテージが必要になる場合があります。percentage()関数を使用すると、指定した条件に一致するデータセット内の値の割合を計算できます。この関数は2つの引数を取ります:1番目は、count()などの目的の属性に対する集計関数です。2番目は、クエリするデータのサブセットを指定するためのWHERE条件です。
このサンプル クエリでは、過去 1 日の期間 (または応答時間) が 100 ミリ秒を超えた API 呼び出しの割合を見つけることができます。
SELECT percentage(count(*), WHERE duration > 0.1) FROM Public_APICall SINCE 1 day ago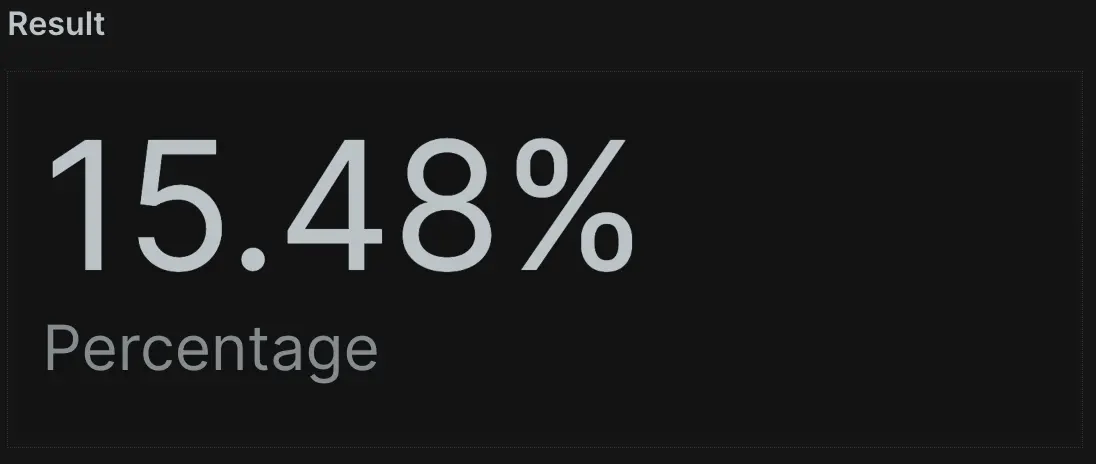
アプリケーションのパフォーマンスや顧客エクスペリエンスのデータを、平均ではなくパーセンタイルを使用して表示するのが非常に一般的です。percentile()関数を使用すると、n 番目のパーセンタイルのエクスペリエンスを理解できます。
たとえば、過去 1 日の顧客エクスペリエンスの 98% のうち、最悪のエクスペリエンス (最長期間) を知りたいとします。過去 24 時間から NRDB にpercentile(duration, 98)を要求できます。
SELECT percentile(duration,98) FROM Public_APICall SINCE 1 day ago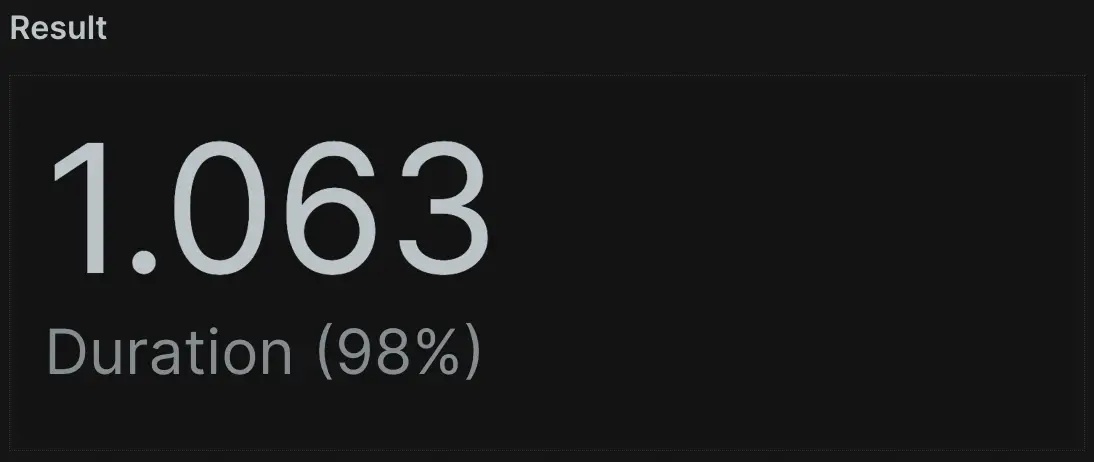
ご覧のとおり、集計によりデータを柔軟に制御できます。uniqueCount()を使用して、特定の属性のユニークなエントリをカウントできます。しかし、これを使用して、ユニークなマシンやレポートコンテナの数を特定したり、New Relicに送信するカスタムデータポイントの数を確認したりすることもできます。また、クエリに使用できるユニーク値を知りたい場合は、いつでもuniques()を使用してリストを取得できます。
latest()関数とearliest()関数は、スパースデータを処理する場合や、何かがレポートを開始または停止した時期を調査する場合に特に役立ちます(New Relicがまだデータを保存していると仮定した場合)。percentage()関数を使用すると、全体の結果セットと比較して、修飾子に一致したイベントの割合を確認できます。最後に、すべてのエンドユーザートランザクションの90%が指定された期間を超えるように目標を設定することで、percentile()を主要パフォーマンス指標として使用できます。
次のステップでは、NRQL を使用して基本的な数学を実行する方法を学びます。
算術演算子を使用する
NRQLは基本的な数学演算子をサポートしています。数値属性値と集計関数の結果の両方に対して、足し算(+)、引き算(-)、掛け算(*)、割り算(/)を実行できます。
たとえば、トランザクションイベントを記録する際、合計レスポンスタイム(durationとして)とデータベースのレスポンスタイム(databaseDurationとして)の両方をキャプチャします。しかし、データベース処理以外に費やされた平均時間を調べたい場合はどうすればよいでしょうか?まずは、次のようなクエリを使用して、データセット内の各イベントのその値を計算することから始めることができます。
SELECT GigabytesIngestedBillable - GigabytesIngestedFree, metric FROM NrMTDConsumption WHERE productLine IS NOT NULL素晴らしい!基本的な計算を実行しました。これは、個々のイベントを一覧表示するのに役立ちます。しかし、データベースの時間を除いたトランザクションの平均所要時間を知りたい場合はどうすればよいでしょうか?関数内で計算を行うこともできます:
SELECT average(GigabytesIngestedBillable - GigabytesIngestedFree) FROM NrMTDConsumption WHERE GigabytesIngestedBillable IS NOT NULLさて、同じクエリ内で減算、除算、乗算をさらに複雑にして、データベース時間を除いた時間を全体時間のパーセンテージとして計算したい場合はどうすればよいでしょうか?さて、次の計算を追加できます。
SELECT average(GigabytesIngestedBillable - GigabytesIngestedFree) / unitPrice * 100 FROM NrMTDConsumption WHERE GigabytesIngestedBillable IS NOT NULLNew Relicはイベントの一部としてタイミングを報告するため、それらを使用してデータポイントを計算したり、パーセンテージ結果を生成したりすることもできます。これらの算術演算子をカスタムアクションやイベント、またはNew Relicに送信するカスタムデータに適用することで、これをさらに拡張できます。例えば、注文規模や支払い方法に関するデータを報告するeコマースプラットフォームでは、計算を使用して、ユニークな顧客の訪問に対する注文のコンバージョン率などを計算できます。
次のステップでは、NRQL を使用して属性にラベルを付ける方法を学習します。
ラベルの属性
より複雑なNRQL関数を実行するようになると、特にNRQLを知らない他のユーザーのために、クエリ属性に表示される名前をよりわかりやすくできないかと考えるかもしれません。前のチュートリアルで学習した内容を使用した例を見てみましょう。
SELECT average(duration-externalDuration) FROM Transaction関数または属性の後にAS句を使用すると、結果により読みやすく意味のある名前を付けることができます。これにより、チャートが正確に何を表しているかをチーム全体で理解しやすくなります。
SELECT average(duration-externalDuration) AS 'Non-External Response Time' FROM Transactionこれは単なる見た目の問題に思えるかもしれませんが、詳細なダッシュボードを構築する場合、データに明確なラベルを付けることが重要です。これにより、ウィジェット、ビルボード、折れ線グラフ、または表を閲覧するすべてのユーザーに対して、データソースが明確になります。
これについては、今後のグループ化に関するレッスンで再度参照し、より高度なシナリオでもASクリーンな結果セットを作成する方法を検討します。次に、さまざまな時間枠でデータを比較する方法を学びます。
時間枠を比較する
ここまでで、 SINCEとUNTIL句で時間範囲を使用する練習をしました。しかし、異なる時間範囲の値を比較したい場合はどうすればよいでしょうか?これは、 COMPARE WITH句を使用して実現できます。
NRQL は、 SINCEとUNTILを使用して対象期間を定義します。次に、相対オフセット値を含むCOMPARE WITH [time period] AGO句を使用して、比較する期間を指定できます。
たとえば、以下のサンプル クエリでは、1 週間前の相対オフセットを使用して、前日のデータと前の週のデータを比較できます。
SELECT average(duration) FROM Public_APICall SINCE 1 day ago COMPARE WITH 1 week ago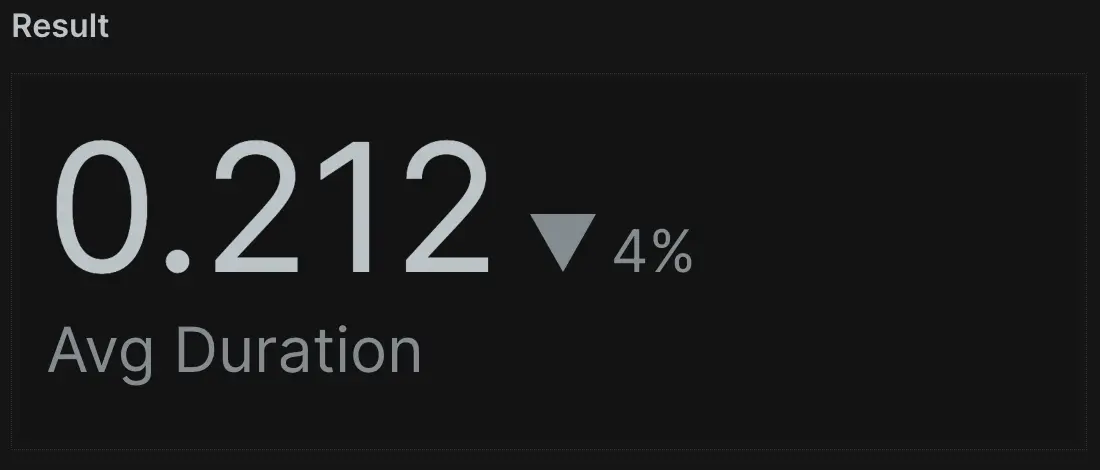
時間の経過に伴う値の比較をマッピングするには、 TIMESERIESを追加します。これにより、比較の折れ線グラフが作成され、この期間が最近のデータとどのように比較されるかを視覚化し、長期にわたって追跡できるようになります。
SELECT average(duration) FROM Public_APICall SINCE 1 day ago COMPARE WITH 1 week ago TIMESERIES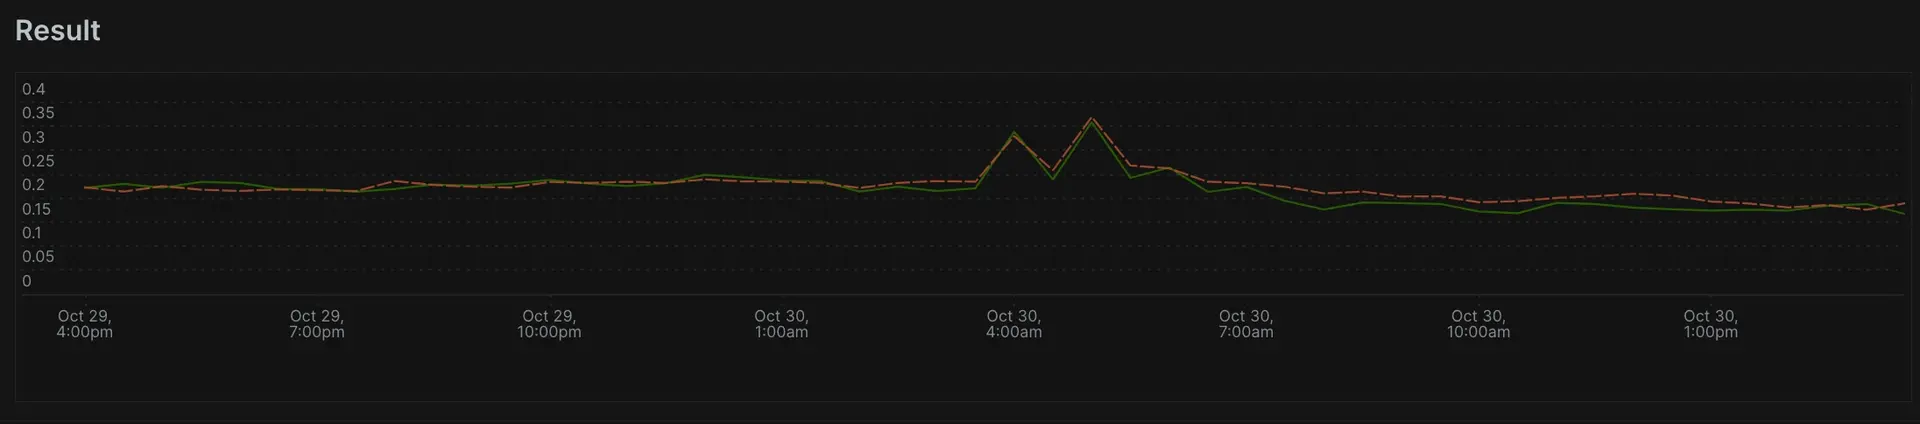
UNTILと同様に、同じ形式でさまざまな相対期間を指定することもできます。たとえば、 4 WEEKS AGOまたは6 HOURS AGOを指定できます。
SELECT average(duration) FROM Public_APICall SINCE 1 hour ago COMPARE WITH 6 hours ago TIMESERIES比較を行うことで、アプリケーションで何が起きているかについての疑問にすばやく答えることができます。先週と比較して、さまざまな売上、パフォーマンス、MTTR、またはエラーの値は上がっていますか、それとも下がっていますか?また、問題を調査している場合、問題のあるパフォーマンスの期間と正常なパフォーマンスの期間を比較すると便利です。
ワイルドカードフィルターを使用する
これで、 WHERE句を使用してクエリの結果をフィルタリングする方法がわかりました。標準の比較演算子を使用する以外に、属性に指定された部分文字列が含まれているかどうかを確認する場合は、 LIKEとNOT LIKEを使用することもできます。これを実現するには、文字列内の任意の場所でパーセント ( % ) 記号をワイルドカードとして使用できます。
サンプルクエリでは、名前のどこか(先頭、中間、または末尾)に"amazonaws"という用語が含まれるトランザクションの数を取得できます。
SELECT count(*) FROM Public_APICall WHERE http.url LIKE '%amazonaws%' FACET http.url SINCE 1 day ago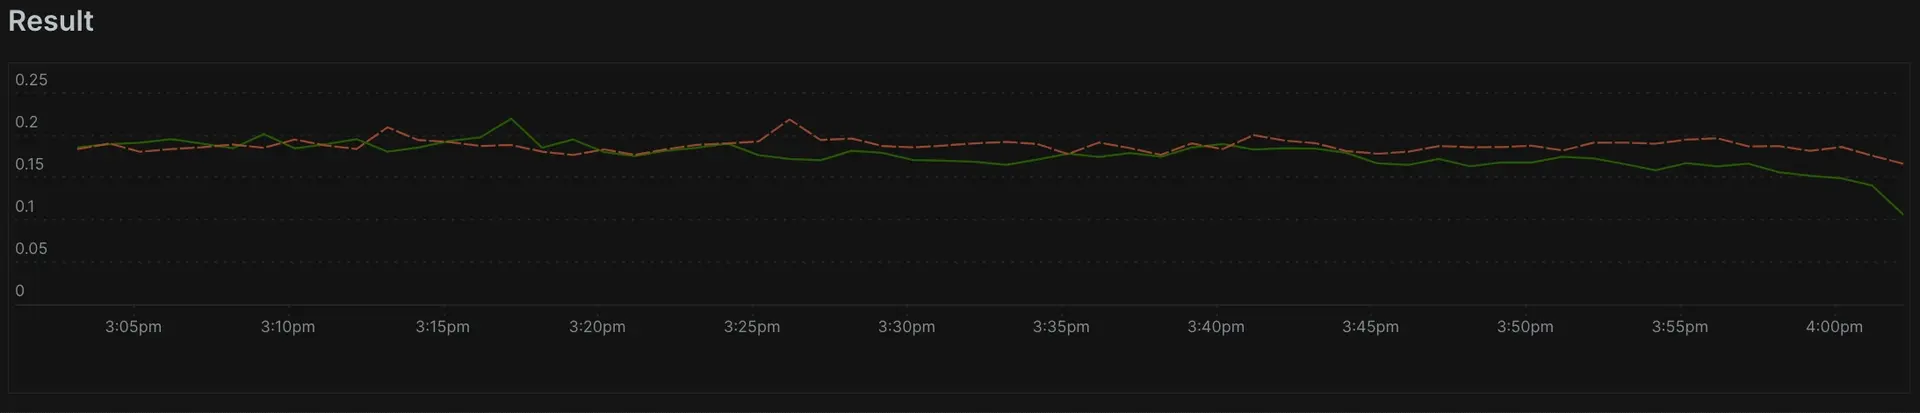
代わりにNOT LIKEを使用するようにクエリを変更すると、選択した単語 (以下の「google」など) が名前に含まれないトランザクションの数が取得されます。
SELECT count(*) FROM Public_APICall WHERE http.url NOT LIKE '%google%' FACET http.url SINCE 1 day ago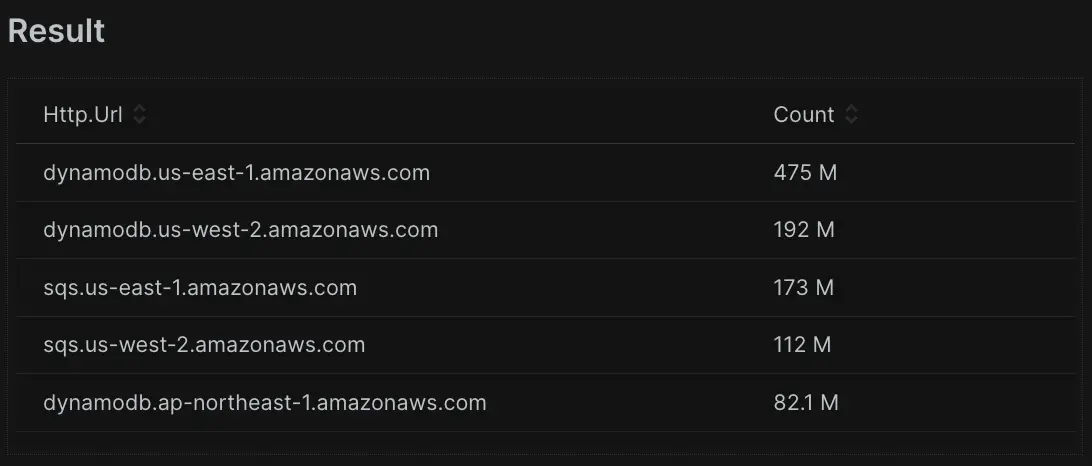
先頭と末尾にワイルドカードとして%を使用できます。これは、選択した属性の値に、テキスト内の任意の場所にある「Web」などの用語が含まれているかどうかをNew Relicがチェックすることを意味します。同様に、%WebまたはWeb%を使用して、それぞれ「Web」で終わるもの、または「Web」で始まるものに一致させることもできます。
より絞り込んだ検索を行うために、文字列の間にワイルドカードを追加することもできます。このクエリは、「amazon」という単語の後に任意のテキストが続き、その後に「.com」という単語も含まれるトランザクション名をチェックします。その後に任意の数の文字が続きます。したがって、結果は名前に「amazon」と「.com」が含まれるトランザクションのみになります。
SELECT count(*) FROM Public_APICall WHERE http.url NOT LIKE '%amazon%.com' FACET http.url SINCE 1 day ago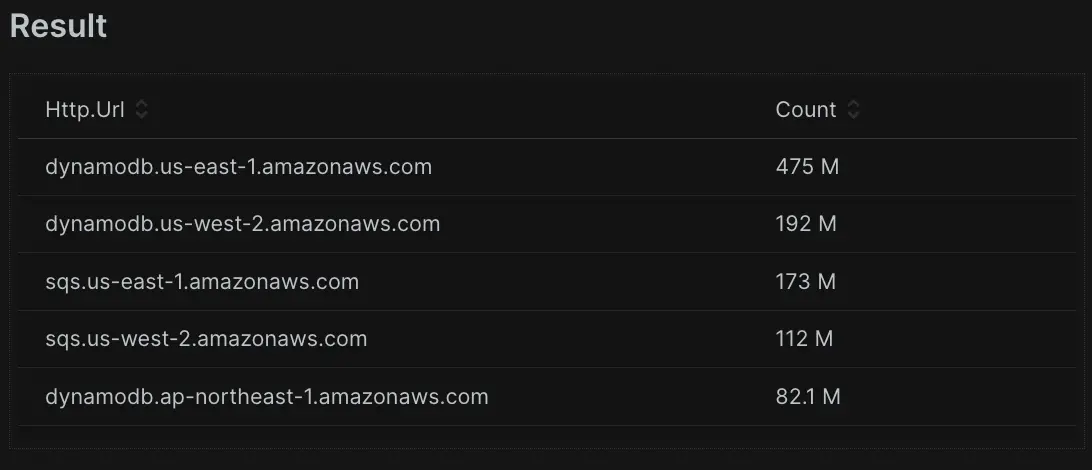
極端な特異性が必要で、ワイルドカードを使用して一致できる共通の文字列が名前にない場合はどうすればよいでしょうか?IN演算子とNOT IN演算子を使用すると、属性に対してチェックする値のセットを指定できます。AND演算子またはOR演算子を使用して複数のWHERE句を指定する代わりに、括弧内の値をカンマで区切ってリストすることで条件を簡素化できます。
このサンプル クエリでは、サブタイプが「graph.microsoft.com」または「s3.amazonaws.com」であるトランザクションの数をカウントできます。代わりにNOT INを使用するようにクエリを変更すると、サブタイプが "graph.microsoft.com" ではないトランザクションの数が取得されます。「s3.amazonaws.com」でもありません。
SELECT count(*) FROM Public_APICall WHERE http.url IN ('graph.microsoft.com', 's3.amazonaws.com') SINCE 1 day ago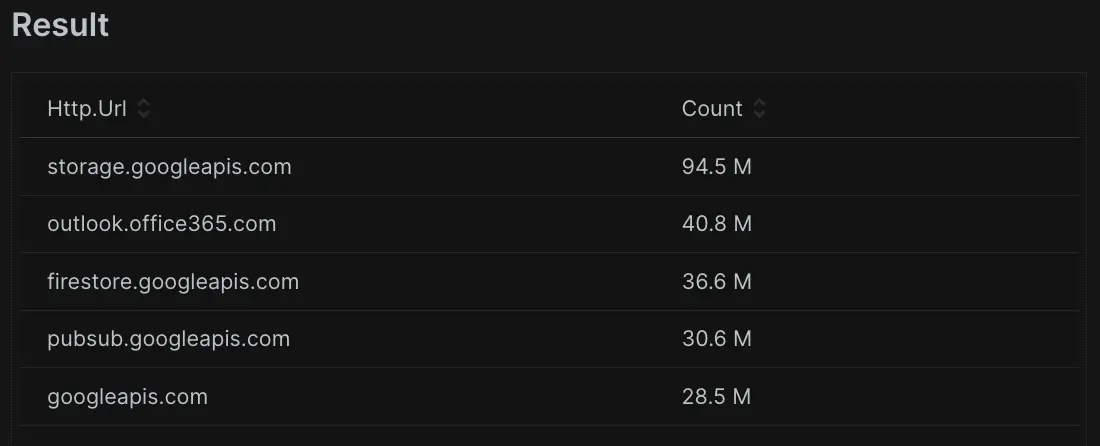
データを制御し、必要な処理を行うために操作することで、ダッシュボードやアラートを構築できるようになりました。次に、NRQLを使用して時間範囲を指定する方法を学びます。
時間範囲を指定する
SINCE句とUNTIL句は、相対的な時間範囲に関する情報を提供するだけではありません:特定の日付や時刻を指定することもできます。以下のサンプルクエリでは、YYYY-MM-DD形式のSINCEの日付を使用できます。
SELECT average(duration) FROM Public_APICall SINCE '2023-10-28' TIMESERIES MAX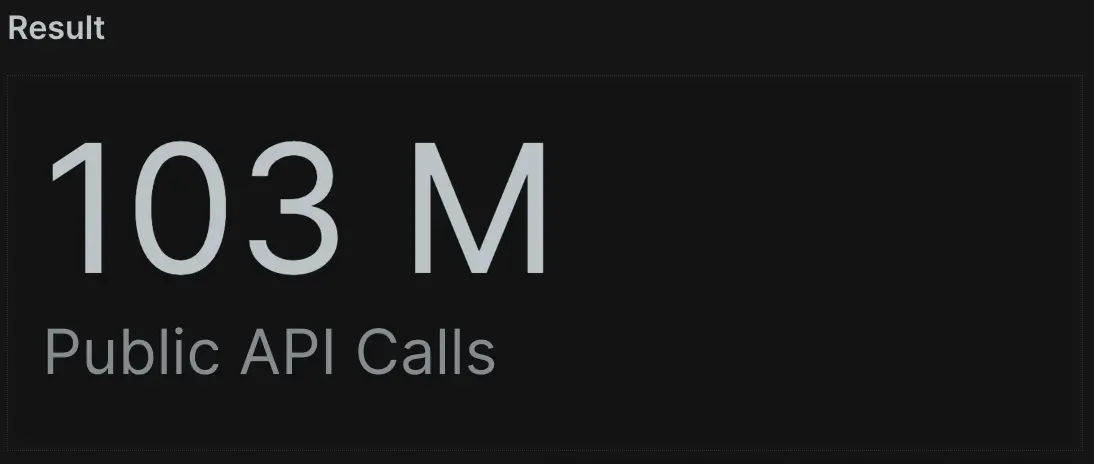
これを使用して、指定した期間のSLAレポートを作成できます。YYYY-MM-DD HH:MMの形式で特定の時間を含めることもできます。このクエリでは、データが午後6時に設定されていることを確認できます。
SELECT average(duration) FROM Public_APICall SINCE '2023-10-28 18:00' TIMESERIES MAX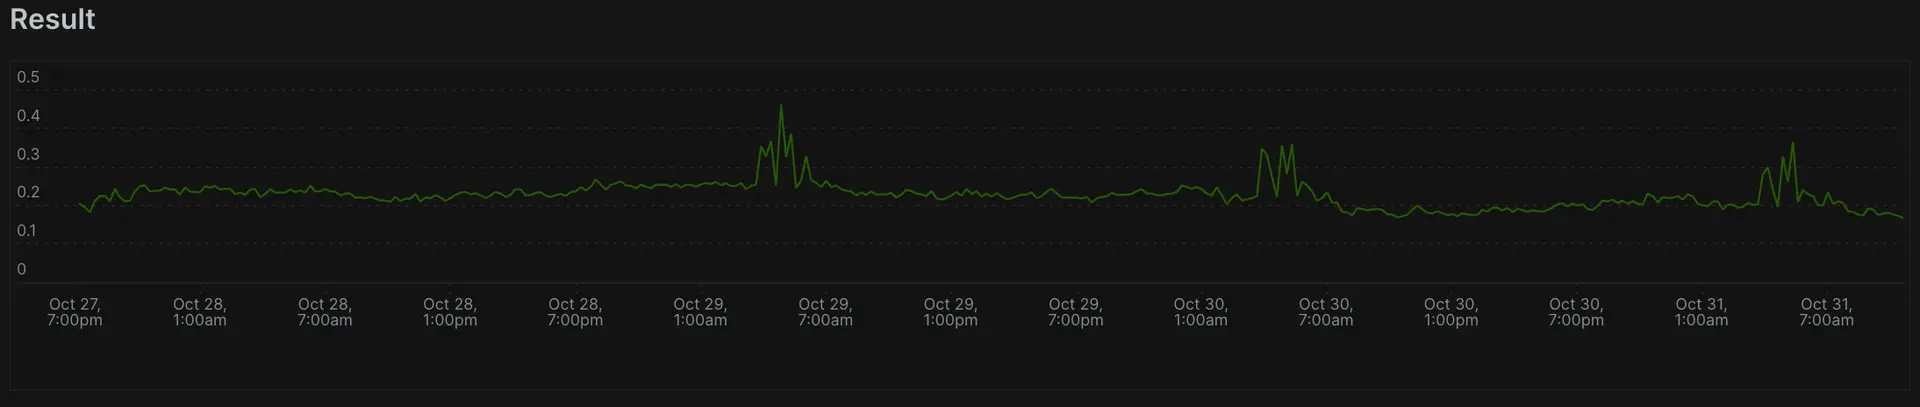
イベント時間をエポック(unix)時間で受け取ることがあります。SINCEおよびUNTIL句でエポックタイムスタンプを使用することもできるため、これらの値を手動で別の日付形式に変換する必要はありません。
SELECT average(duration) FROM Public_APICall SINCE 1698525489519 UNTIL 1698698289519 TIMESERIES MAX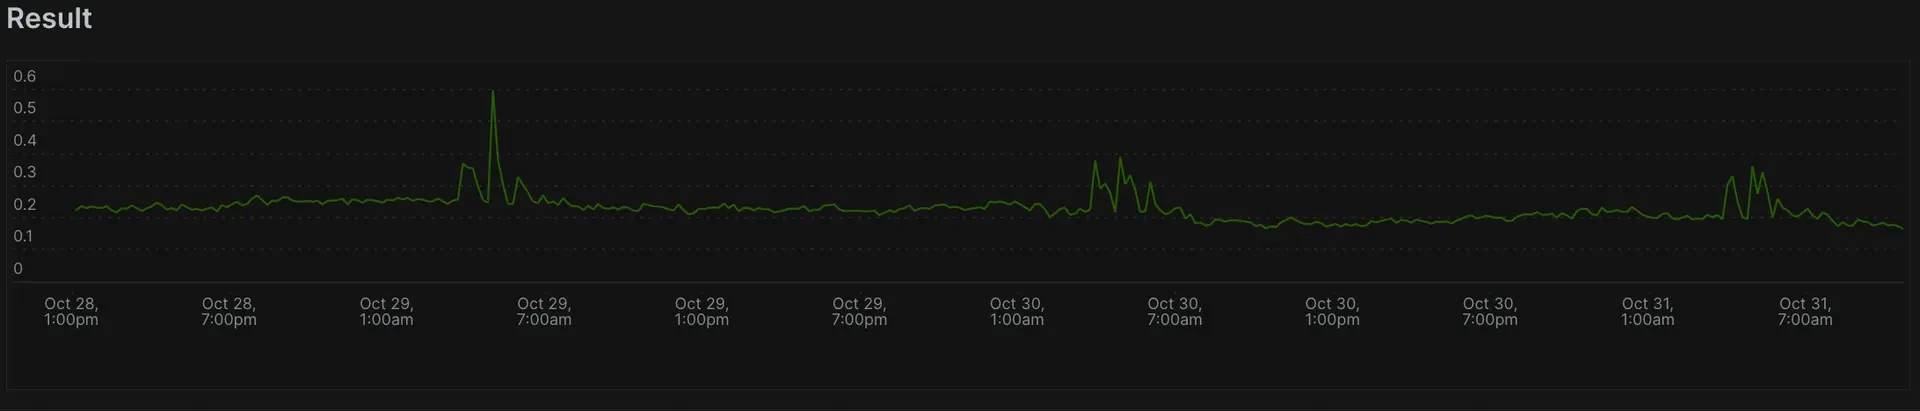
NRDB は、一定期間にわたるデータを表示する場合、ユーザーがタイムゾーンの観点からデータを表示することを想定しています。しかし、国際チームが分散している場合、チームメイトの所在地に応じて、あなたの今日が明日、あるいは昨日になる可能性があります。WITH TIMEZONE句を使用して、データを表示するタイムゾーンを定義できます。これは、 SINCEとUNTIL句の値の解釈に影響します。
以下の 2 つのグラフの例を考えてみましょう。各クエリには、 WITH TIMEZONEを使用して指定されたタイムゾーンがあります。両者の時差は8時間です。データのパターンは同じですが、それぞれのタイムゾーンに合わせて 8 時間オフセットしていることに注目してください。
SELECT count(*) FROM Public_APICall SINCE yesterday UNTIL today WITH TIMEZONE 'America/Los_Angeles' TIMESERIES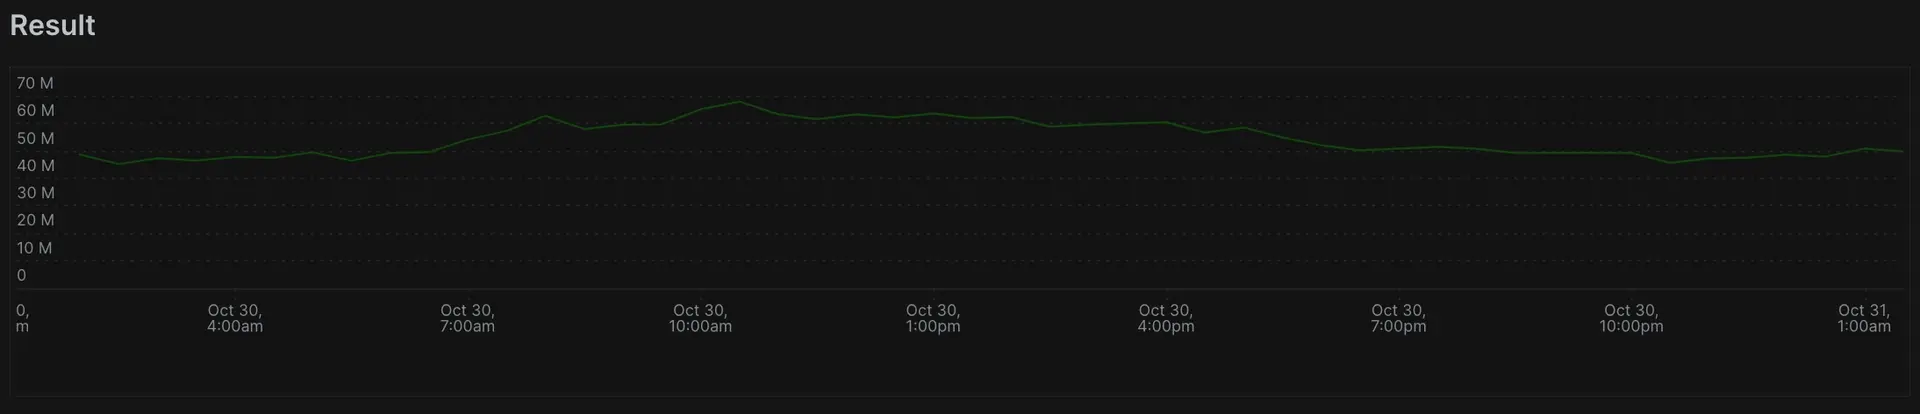
SELECT count(*) FROM Public_APICall SINCE yesterday UNTIL today WITH TIMEZONE 'Europe/London' TIMESERIES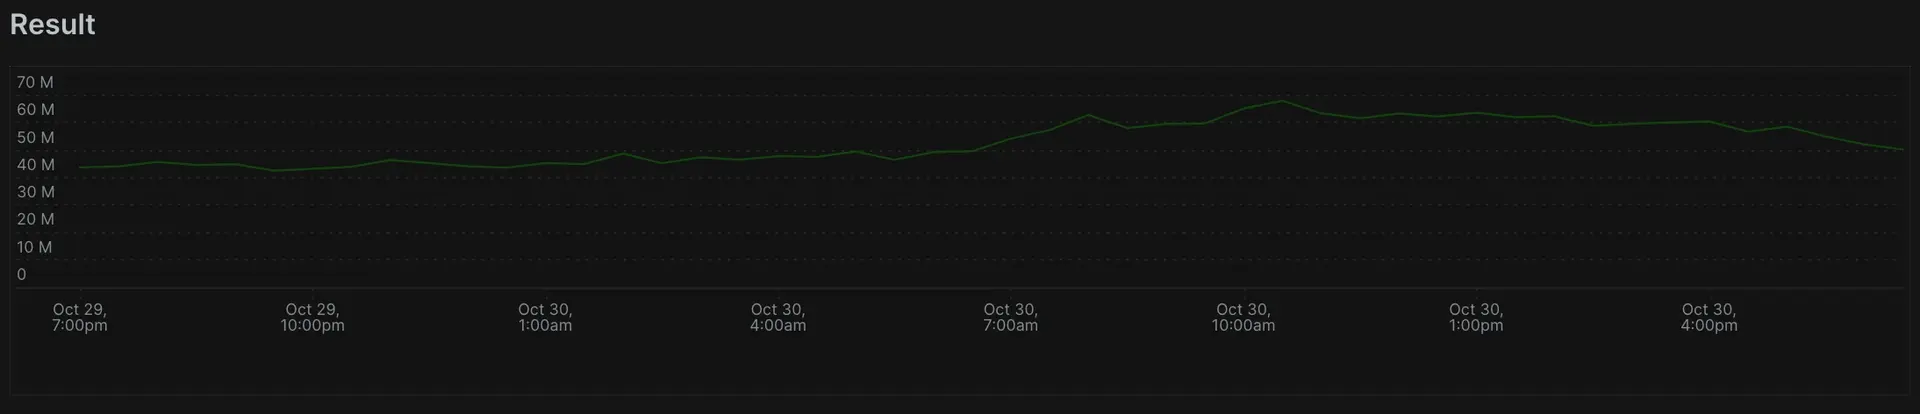
このレッスン以前は、すべての時間制御メカニズムは現在からの相対的な時間に依存していました。今では、世界中の誰かの場所に応じてビューを調整できます。たとえば、東海岸の顧客が、西海岸にあるエンジニアリングチームに問題を報告したとします。チームはダッシュボードを構築し、顧客が言及するタイムゾーンにマッピングするようにビューを変換できます。そのため、東海岸の午前9時に顧客が問題を報告した場合、午前9時を見たときに、頭の中で時差を計算する必要がなくなります。
集計イベントの特定の日付に焦点を当てる必要があり、現在の時間に対する移動時間枠なしでデータを調査したい場合、これは静的な時間枠でデータを取得するのに役立ちます。次の最後のレッスンでは、時間ベースのコホートを使用してレポートで時間を使用する方法を引き続き学習します。
時間ベースのコホートを使用する
複雑に聞こえるかもしれませんが、時間ベースのコホートは、単にデータをminuteOf 、 hourOf 、 weekOfなどの時間ベースのグループに整理する方法を意味します。
期間に対してSINCE句を使用すると、クエリされた期間全体の長さを取得できます。しかし、そのデータが常に全体像を物語っているとは限りません!特定の期間内のパフォーマンスをより詳細に分析する必要がある場合はどうすればよいでしょうか?時間ベースのコホートを使用すると、データを論理的で時間ベースのグループにさらに分類できます。
FACETと多くの時間ベースの関数 ( hourOf(timestamp)など) の 1 つを組み合わせて使用すると、1 週間分のデータを取得し、発生した特定の時間に基づいてパフォーマンスを把握できます。これにより傾向が明らかになり、アプリケーションにとって最もクリティカルな時期が特定されます。
SELECT average(duration) FROM Public_APICall FACET hourOf(timestamp) SINCE 1 week ago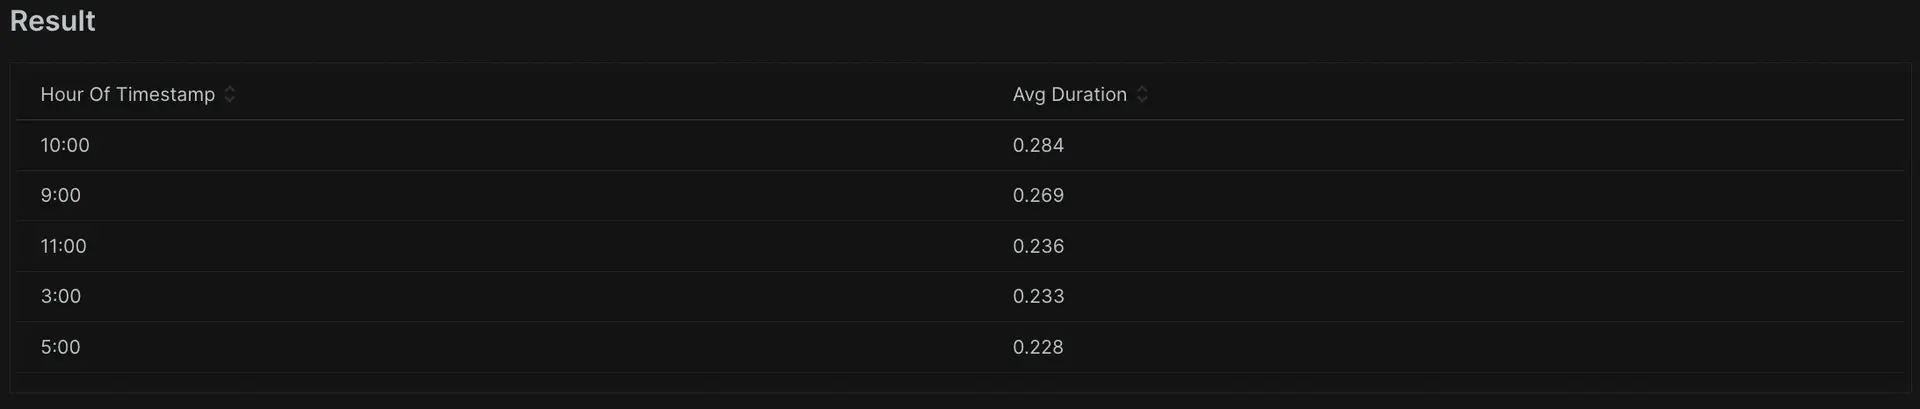
上記のクエリを実行すると、時間帯ごとの最も遅いレスポンスタイムを確認できます。New Relicは、時間に基づいてファセットするためのさまざまなオプションを提供します。前の例では時間ごとにグループ化していますが、曜日ごとにグループ化して、どの曜日のレスポンスタイムが最も良く、どの曜日が最も悪いかを判断することもできます。
SELECT average(duration) FROM Public_APICall FACET weekdayOf(timestamp) SINCE 1 week ago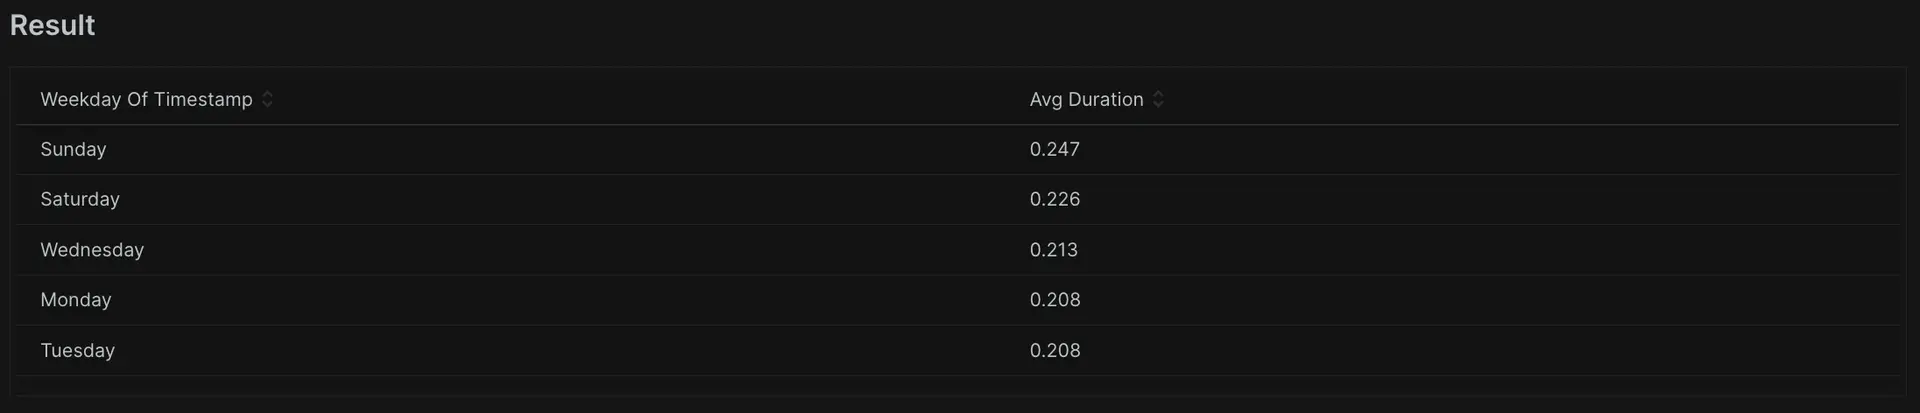
特定の日のアプリケーションの最も遅い期間を確認できるようになりました。これを使用して、「製品が最も多く売れるのはいつですか?」などのビジネスクリティカルな質問に答えることができます。または「サインアップまたはログインが最も多いのはいつですか?」
結果を特定の日付でグループ化することもできます。これは、SLA レポートを検討する場合や、一定期間のパフォーマンスの変化を分析する場合に役立ちます。
SELECT average(duration) FROM Public_APICall FACET dateOf(timestamp) SINCE 1 week ago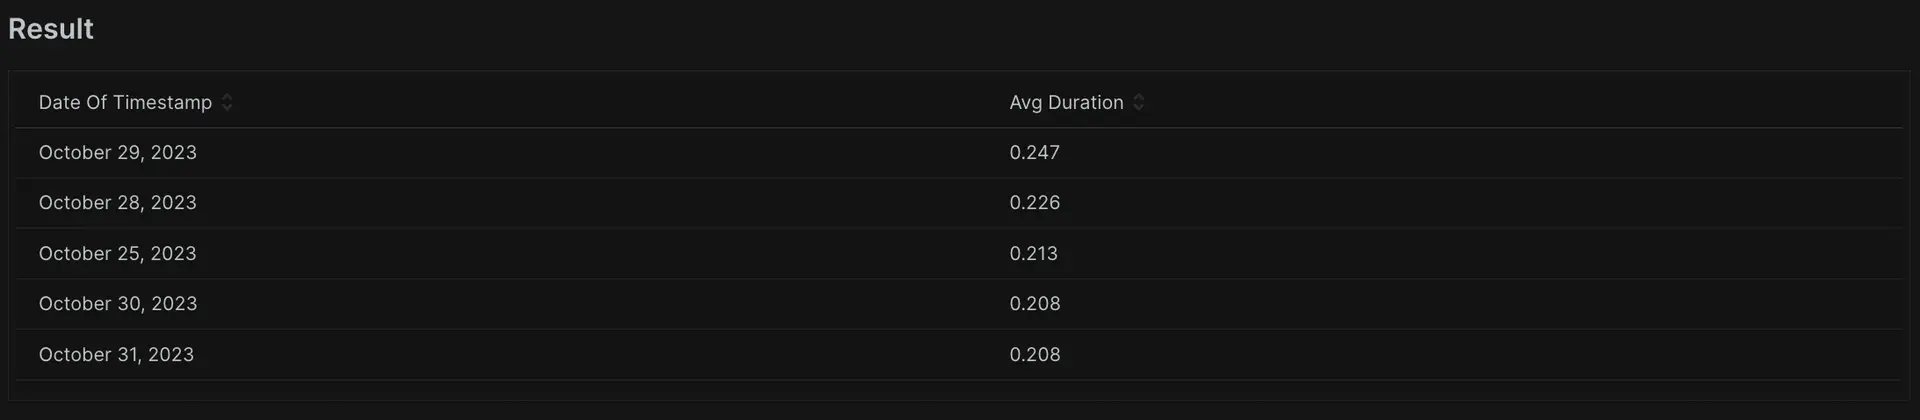
時間ベースのコホート分析により、特定の分、時間、日、または週に発生する問題を明らかにすることができます。New Relicにどのようなデータを送信しても、NRQLを使用すると、必要なあらゆる形式でデータをスライス、ダイス、整理、視覚化できます。
データ保持期間に応じて、週、月、年など、グループ化に使用できるオプションは他にも多数あります。完全なリストについては、Group Results Across Timeのドキュメントページをご覧ください。
次のステップ
ここで得た知識を活用して、ダッシュボードの視覚化を作成し、最も関心のあるデータの側面を制御できます。これらの手法を使用して、より詳細で具体的なアラートに焦点を絞り、より詳細な視覚化を作成できます。準備ができたら、3番目のチュートリアルに進むことができます。ここでは、フィルター、ファセットケース、ヒストグラム、Apdex、eventTypeへのフィルタリング、値のオーバーライド、外挿など、追加のNRQLスキルを学びます。