첫 번째 NRQL 튜토리얼에서는 쿼리 작성의 기본 사항을 살펴보았습니다. 기본 쿼리 구조, 시간대 정의, 관찰할 특정 속성을 선택하는 방법을 다루었습니다. 또한 그래프 및 기타 시각화를 사용하여 데이터를 집계하고 표시하는 방법도 배웠습니다.
이 튜토리얼에서는 유용한 집계를 생성하기 위한 더 많은 기능을 좀 더 자세히 살펴보겠습니다. 여기에서는 반환된 데이터를 이전 기간과 비교하고 데이터를 특정 기간으로 그룹화하는 방법을 알아봅니다. 또한 SINCE 및 UNTIL 기능과 관련된 더 많은 작업을 알아보고 필터에서 와일드카드를 사용하는 방법을 살펴보겠습니다. 구체적으로 다음 방법을 배우게 됩니다.
- 다음을 사용하여 고유한 값을 쿼리합니다.
uniques(attributeName) - 다음을 사용하여 속성에 존재하는 고유 값 수를 확인합니다.
uniqueCount(attributeName) - 특정 기간 내에
earliest(attributeName)및latest(attributeName)검색 - 다음을 사용하여 한정자 또는 기타 데이터 포인트를 기반으로 백분율을 계산합니다.
percentile() - 속성과 집계 함수 또는 둘의 조합을 사용하여 기본 수학을 수행합니다.
- 속성 이름을 사용자 정의하고 읽기 쉬운 이름으로 변환
LIKE또는NOT LIKE과(와) 함께 와일드카드를 사용하여 포함/제외를 검색하거나, 결과를 목록의IN또는 해당 목록의NOT IN(으)로 제한하십시오.- 날짜, 에포크 및 시간을 사용하여 고급 기간 내에서 쿼리
WITH TIMEZONE - 시간 기반 코호팅을 사용하여 데이터를 시간 창으로 그룹화합니다.
시작하자!
집계 함수
첫 번째 NRQL 튜토리얼을 완료한 후, count(), average(), sum(), max() 및 min()을(를) 사용하여 의미 있는 방식으로 데이터를 변환했습니다. 하지만 고유값을 찾고 계산하려면 어떻게 해야 합니까? 지정된 시간 범위 동안 속성에 대해 기록된 고유값의 수를 찾으려면 uniqueCount() 함수를 사용할 수 있습니다. 검사하려는 속성을 인수로 제공하기만 하면 됩니다. 예를 들어, 다음은 모든 고유한 퍼블릭 API 호출을 표시하는 쿼리입니다:
SELECT uniqueCount(http.url) FROM Public_APICall SINCE 1 day ago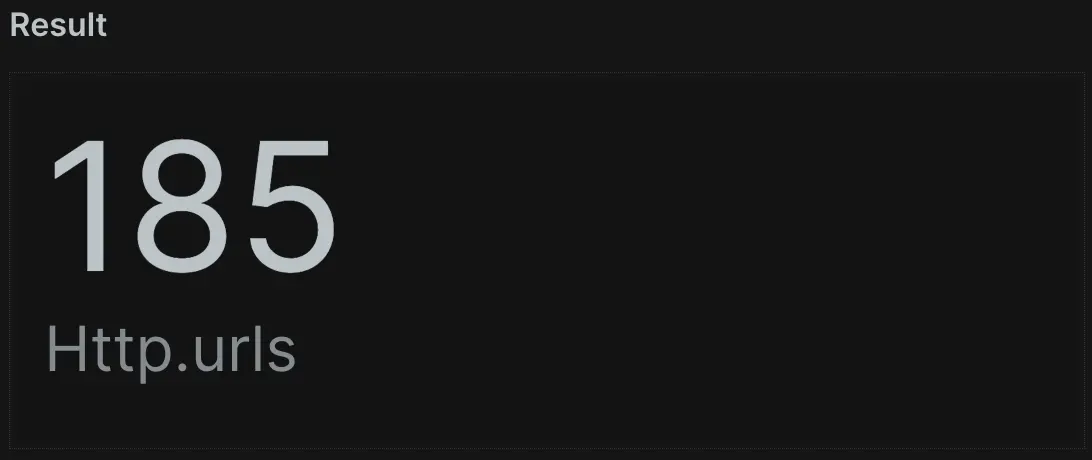
쿼리 성능을 최적화하기 위해 위 함수는 256개 이상의 고유 값을 검사하는 쿼리에 대한 대략적인 결과를 반환합니다. 지정된 기간 동안 속성에 대한 고유 값의 실제 목록을 반환하려면 uniques() 함수를 사용하면 됩니다.
SELECT uniques(http.url) FROM Public_APICall SINCE 1 day ago기본값인 1,000과 다른 제한 값을 지정하려면 최대 10,000까지 허용하는 uniques(attribute[,limit])을(를) 사용하십시오.
지정된 기간 동안 속성의 최신 값을 검색하려면 latest() 함수를 사용하세요. 이 샘플 쿼리에서는 마지막 날의 API 호출에 대한 가장 최근 응답 시간을 찾을 수 있습니다. 이는 간헐적으로 보고되는 거래 또는 서비스의 최신 값을 찾는 데 도움이 될 수 있습니다.
SELECT latest(duration) FROM Public_APICall WHERE awsAPI = 'sqs' SINCE 1 day ago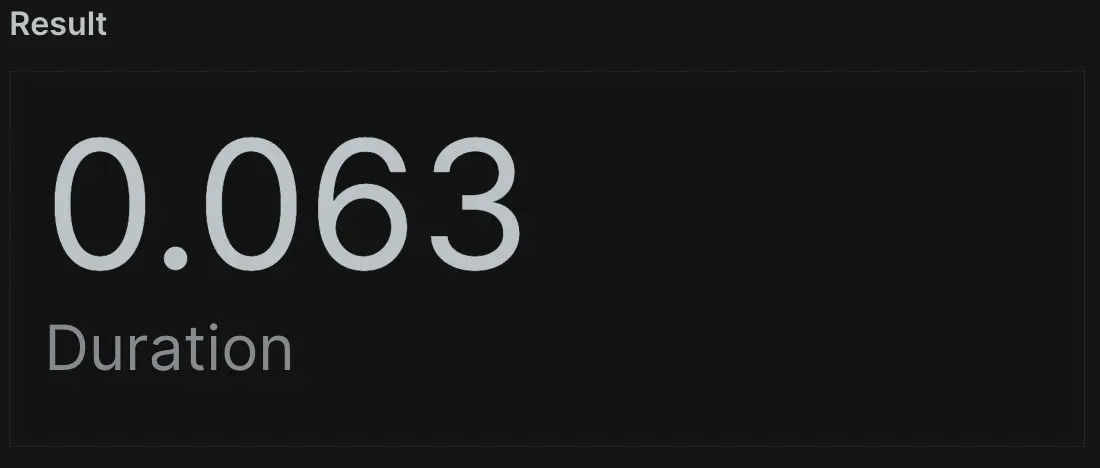
스펙트럼의 반대편에서는 earliest() 함수를 사용하여 그 반대를 달성할 수 있습니다. 지정된 시간 범위에 기록된 속성 중 가장 빠른 값을 반환합니다. 이 샘플 쿼리에서는 마지막 날의 API 호출에 대한 가장 빠른 응답 시간을 검색할 수 있습니다. 데이터가 지속적으로 보고되는 경우 지난 24시간 동안 가장 빠른 이벤트의 데이터 포인트가 보고됩니다.
SELECT earliest(duration) FROM Public_APICall WHERE awsAPI = 'sqs' SINCE 1 day ago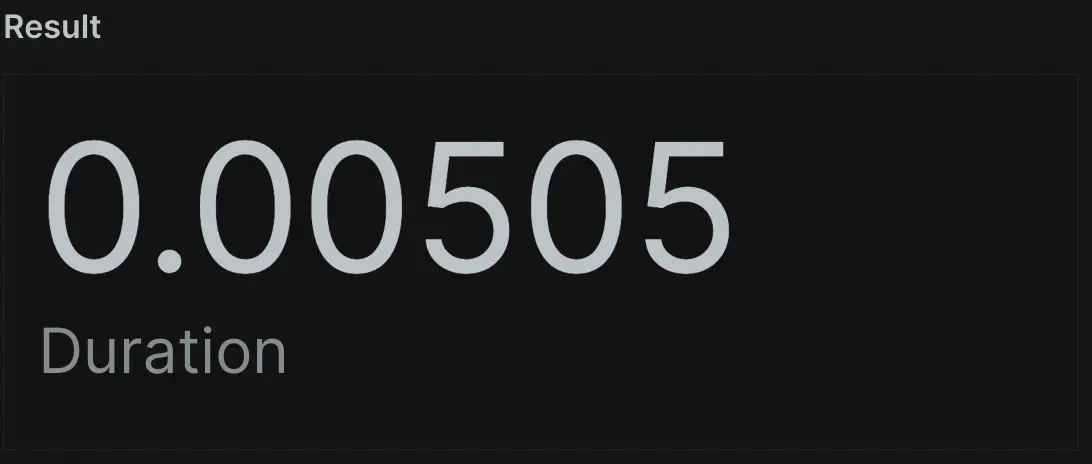
개수, 합계 또는 평균 대신 백분율이 필요할 수 있습니다. percentage() 함수를 사용하면 지정된 조건과 일치하는 데이터 세트 내 값의 백분율을 계산할 수 있습니다. 이 함수는 두 개의 인수를 사용합니다: 첫 번째는 count()과(와) 같이 원하는 속성에 대한 집계자 함수입니다. 두 번째는 쿼리할 데이터의 하위 세트를 지정하는 WHERE 조건입니다.
이 샘플 쿼리에서는 지난 날 기간(또는 응답 시간)이 100밀리초를 초과한 API 호출의 비율을 확인할 수 있습니다.
SELECT percentage(count(*), WHERE duration > 0.1) FROM Public_APICall SINCE 1 day ago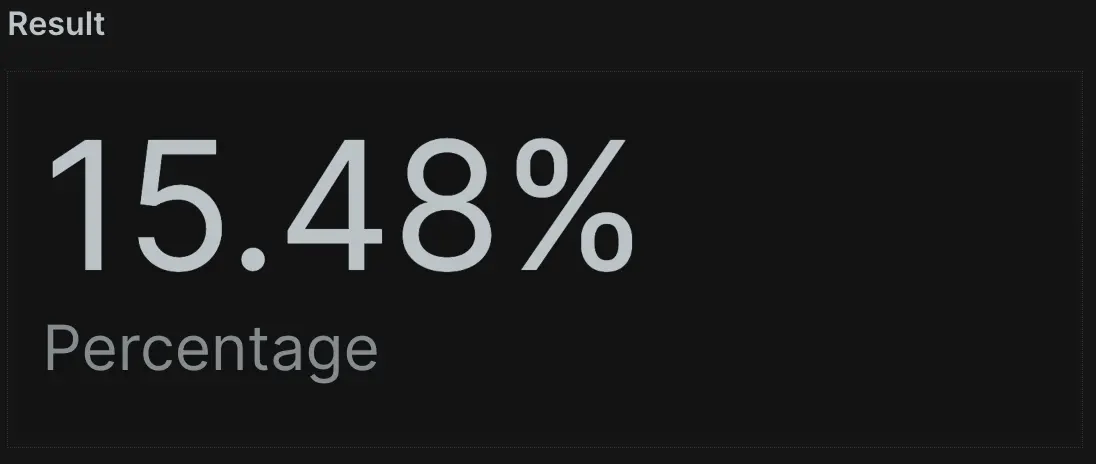
평균이 아닌 백분위수를 사용하여 애플리케이션 성능이나 고객 경험 데이터를 보는 것은 매우 일반적입니다. percentile() 함수를 사용하면 n번째 백분위수의 경험을 이해할 수 있습니다.
예를 들어, 지난 하루 동안 고객 경험 중 98% 중 최악의 경험(최고 기간)이 무엇인지 알고 싶다고 가정해 보겠습니다. 지난 24시간 동안의 percentile(duration, 98) 에 대해 NRDB에 요청할 수 있습니다.
SELECT percentile(duration,98) FROM Public_APICall SINCE 1 day ago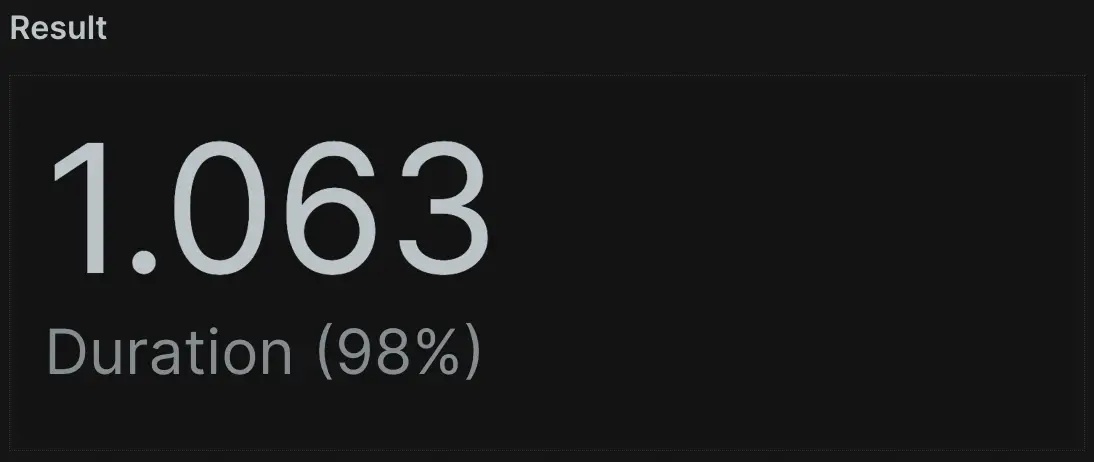
보시다시피 집계를 통해 데이터를 유연하게 제어할 수 있습니다. uniqueCount()을(를) 사용하여 특정 속성의 고유 항목을 계산할 수 있습니다. 하지만 이를 사용하여 고유한 시스템, 보고 컨테이너의 수를 식별하거나 뉴렐릭에 전송하는 사용자 지정 데이터 포인트의 수를 확인할 수도 있습니다. 또한 쿼리할 수 있는 고유값이 무엇인지 알고 싶다면 언제든지 uniques()을(를) 사용하여 목록을 요청할 수 있습니다.
latest() 및 earliest() 함수는 희소 데이터를 처리하거나 무언가가 보고를 시작하거나 중지한 시점을 조사할 때(뉴렐릭이 여전히 데이터를 저장한다고 가정할 때) 특히 유용합니다. percentage() 함수는 전체 결과 세트와 비교하여 한정자와 일치하는 이벤트의 백분율을 보여줄 수 있습니다. 마지막으로, 모든 최종 사용자 트랜잭션의 90%가 제공된 기간을 초과하도록 목표를 설정하여 percentile()을(를) 핵심 성과 지표(KPI)로 사용할 수 있습니다.
다음 단계에서는 NRQL을 사용하여 기본적인 수학을 수행하는 방법을 배우게 됩니다.
수학 연산자 사용
NRQL은 기본 수학 연산자를 지원합니다. 숫자 속성 값과 집계자 함수의 결과 모두에 대해 덧셈(+), 뺄셈(-), 곱셈(*) 및 나눗셈(/)을 수행할 수 있습니다.
예를 들어, 트랜잭션 이벤트를 기록할 때 총 응답 시간(duration(으)로)과 데이터베이스 응답 시간(databaseDuration(으)로)을 모두 캡처합니다. 하지만 데이터베이스 처리 외부에서 소요된 평균 시간을 찾으려면 어떻게 해야 합니까? 이와 같은 쿼리를 사용하여 데이터 세트의 각 이벤트에 대해 해당 값을 계산하는 것으로 시작할 수 있습니다.
SELECT GigabytesIngestedBillable - GigabytesIngestedFree, metric FROM NrMTDConsumption WHERE productLine IS NOT NULL좋습니다! 방금 몇 가지 기본 수학 연산을 수행했습니다. 이는 개별 이벤트를 나열하는 데 유용합니다. 하지만 데이터베이스 시간을 제외한 트랜잭션의 평균 소요 시간을 알고 싶다면 어떻게 해야 합니까? 함수 내에서 산술 연산을 수행할 수도 있습니다:
SELECT average(GigabytesIngestedBillable - GigabytesIngestedFree) FROM NrMTDConsumption WHERE GigabytesIngestedBillable IS NOT NULL이제 데이터베이스 시간 없이 기간을 전체 시간의 백분율로 계산하기 위해 동일한 쿼리에서 빼기, 나누기, 곱셈을 통해 훨씬 더 복잡해지고 싶다면 어떻게 해야 합니까? 음, 수학을 추가할 수 있습니다:
SELECT average(GigabytesIngestedBillable - GigabytesIngestedFree) / unitPrice * 100 FROM NrMTDConsumption WHERE GigabytesIngestedBillable IS NOT NULL뉴렐릭은 이벤트의 일부로 타이밍을 보고하므로, 이를 사용하여 데이터 포인트를 계산하거나 백분율 결과를 생성할 수도 있습니다. 이러한 수학 연산자를 사용자 지정 작업이나 이벤트, 또는 뉴렐릭으로 전송하는 사용자 지정 데이터에 적용하여 이를 더욱 확장할 수 있습니다. 예를 들어, 주문 규모 및 결제 방법에 대한 데이터를 보고하는 전자 상거래 플랫폼은 수학을 사용하여 고유 고객 방문 대비 주문의 전환율과 같은 항목을 계산할 수 있습니다.
다음 단계에서는 NRQL을 사용하여 속성에 라벨을 지정하는 방법을 알아봅니다.
라벨 속성
더 복잡한 NRQL 함수를 수행하기 시작하면, 특히 NRQL을 모르는 다른 사람들을 위해 쿼리 속성에 표시되는 이름을 더 유용하게 만들 수 있는지 궁금할 수 있습니다. 이전 튜토리얼에서 배운 내용을 사용하여 예를 살펴보겠습니다.
SELECT average(duration-externalDuration) FROM Transaction함수나 속성 뒤에 AS 절을 사용하여 결과에 더 읽기 쉽고 의미 있는 이름을 지정할 수 있습니다. 이는 팀이 차트가 나타내는 내용을 정확히 이해하는 데 도움이 됩니다.
SELECT average(duration-externalDuration) AS 'Non-External Response Time' FROM Transaction이것은 단지 미적인 것처럼 보일 수 있지만, 상세한 대시보드를 구축할 때는 데이터에 명확하게 레이블을 지정하는 것이 중요합니다. 이렇게 하면 위젯, 빌보드, 꺾은선형 차트 또는 테이블을 보는 모든 사람에게 데이터 소스가 명확해집니다.
그룹화에 대한 다음 강의에서 이를 다시 참조하여 AS 고급 시나리오에서도 깔끔한 결과 집합을 생성할 수 있는 방법을 살펴보겠습니다. 다음으로 다양한 기간의 데이터를 비교하는 방법을 알아봅니다.
기간 비교
지금까지 SINCE 및 UNTIL 절과 함께 시간 범위를 사용하는 방법을 연습했습니다. 하지만 서로 다른 시간 범위의 값을 비교하려면 어떻게 해야 할까요? COMPARE WITH 절을 사용하여 이를 달성할 수 있습니다.
NRQL은 SINCE 및 UNTIL 사용하여 관심 기간을 정의합니다. 그런 다음 상대 오프셋 값이 포함된 COMPARE WITH [time period] AGO 절을 사용하여 비교하려는 기간을 표시할 수 있습니다.
예를 들어 아래 샘플 쿼리에서는 1주 전의 상대 오프셋을 사용하여 마지막 날의 데이터를 이전 주의 데이터와 비교할 수 있습니다.
SELECT average(duration) FROM Public_APICall SINCE 1 day ago COMPARE WITH 1 week ago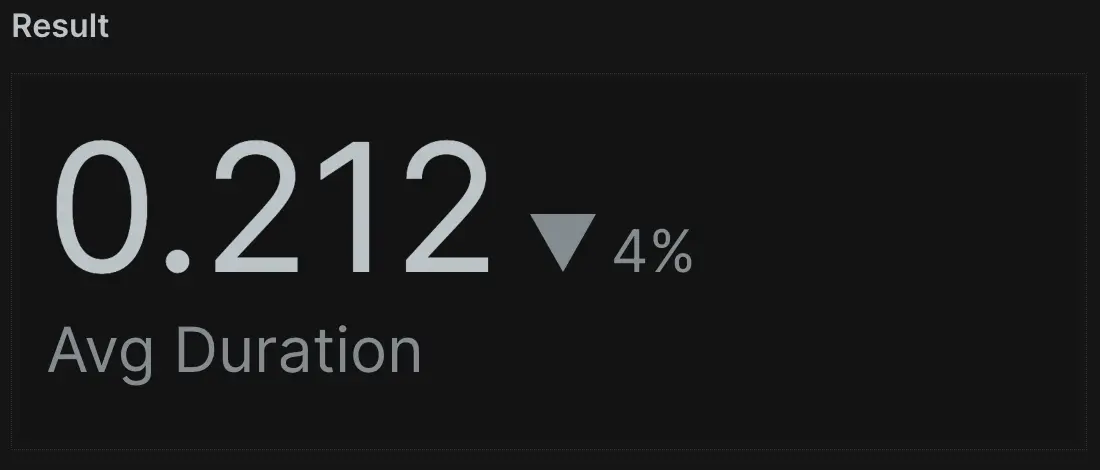
시간 경과에 따른 값 비교를 매핑하려면 TIMESERIES 추가하세요. 이렇게 하면 비교에 대한 선 차트가 생성되어 이 기간을 최근 데이터와 어떻게 비교하는지 시각화하고 시간 경과에 따라 추적할 수 있습니다.
SELECT average(duration) FROM Public_APICall SINCE 1 day ago COMPARE WITH 1 week ago TIMESERIES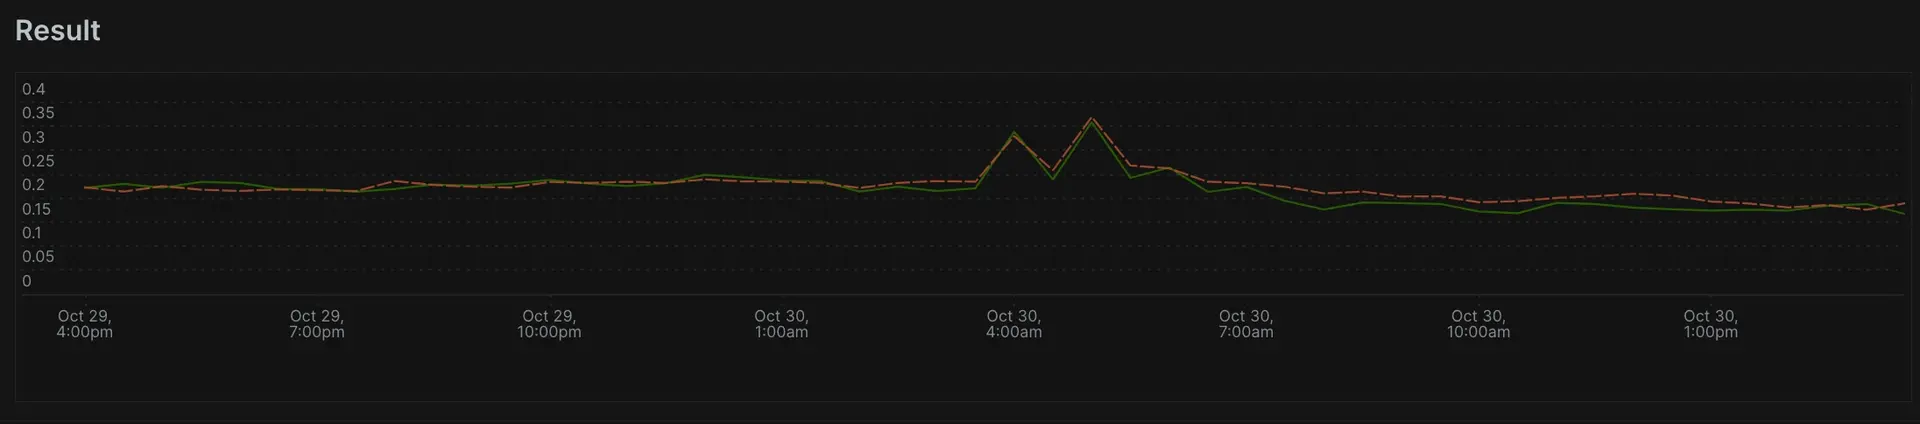
UNTIL 과 유사하게 동일한 형식으로 다양한 상대 기간을 지정할 수도 있습니다. 예를 들어, 4 WEEKS AGO 또는 6 HOURS AGO 지정할 수 있습니다.
SELECT average(duration) FROM Public_APICall SINCE 1 hour ago COMPARE WITH 6 hours ago TIMESERIES비교를 통해 애플리케이션에서 발생하는 상황에 대한 질문에 빠르게 답할 수 있습니다. 지난주와 비교하여 다양한 판매, 성능, MTTR 또는 오류 값이 상승했습니까, 아니면 하락했습니까? 또한 문제를 조사하는 경우 문제가 있는 성능 기간과 정상적인 성능 기간을 비교하는 것이 유용하다는 것을 알게 될 것입니다.
와일드카드 필터 사용
이제 WHERE 절을 사용하여 쿼리 결과를 필터링하는 방법을 알았습니다. 표준 비교 연산자를 사용하는 것 외에도 속성에 지정된 하위 문자열이 포함되어 있는지 여부를 찾으려면 LIKE 및 NOT LIKE 사용할 수도 있습니다. 이를 달성하려면 문자열 어디에서나 백분율(%) 기호를 와일드카드로 사용할 수 있습니다.
샘플 쿼리에서는 이름의 어느 곳(시작, 중간 또는 끝)에나 "amazonaws"라는 용어가 포함된 트랜잭션 수를 가져올 수 있습니다.
SELECT count(*) FROM Public_APICall WHERE http.url LIKE '%amazonaws%' FACET http.url SINCE 1 day ago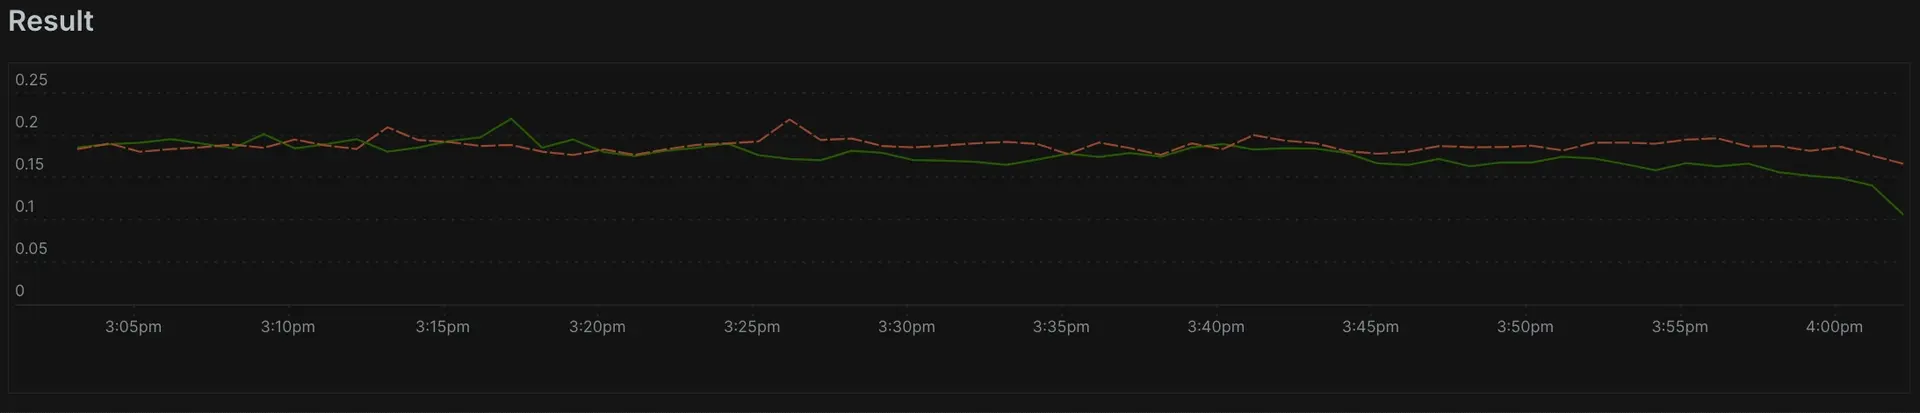
대신 NOT LIKE 사용하도록 쿼리를 변경하면 이름에 선택한 단어(예: 아래와 같이 'google')가 포함되지 않은 거래 수를 얻게 됩니다.
SELECT count(*) FROM Public_APICall WHERE http.url NOT LIKE '%google%' FACET http.url SINCE 1 day ago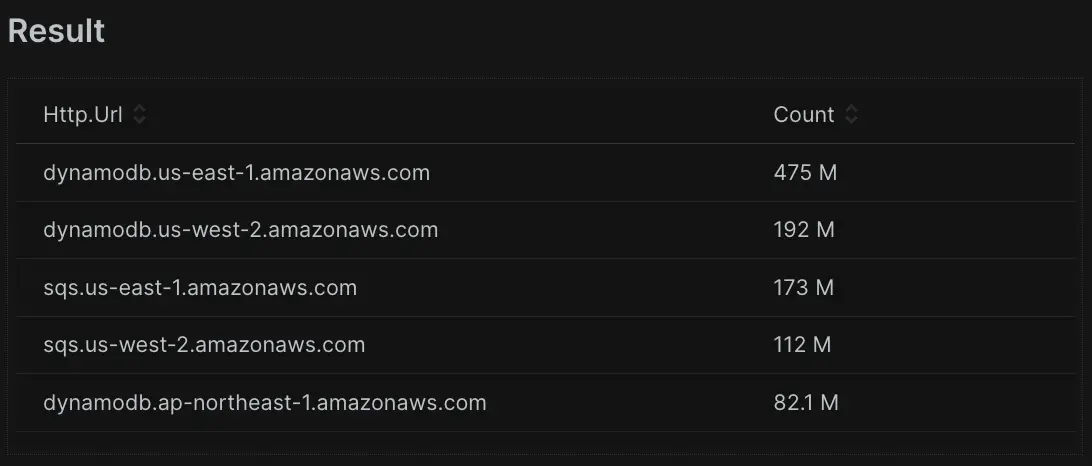
시작과 끝에 %을(를) 와일드카드로 사용할 수 있습니다. 이는 뉴렐릭이 선택한 속성의 값 텍스트 내 어디에든 "Web"과 같은 용어가 포함되어 있는지 확인함을 의미합니다. 마찬가지로 %Web 또는 Web%를 사용하여 각각 "Web"으로 끝나거나 "Web"으로 시작하는 항목을 일치시킬 수 있습니다.
보다 세분화된 검색을 위해 문자열 사이에 와일드카드를 추가할 수도 있습니다. 이 쿼리는 "amazon"이라는 단어와 텍스트가 포함되어 있고 ".com"이라는 용어도 포함되어 있는 거래 이름을 확인합니다. 그 뒤에는 임의 개수의 문자가 옵니다. 따라서 결과는 이름에 "amazon" 및 ".com"이 포함된 거래만 됩니다.
SELECT count(*) FROM Public_APICall WHERE http.url NOT LIKE '%amazon%.com' FACET http.url SINCE 1 day ago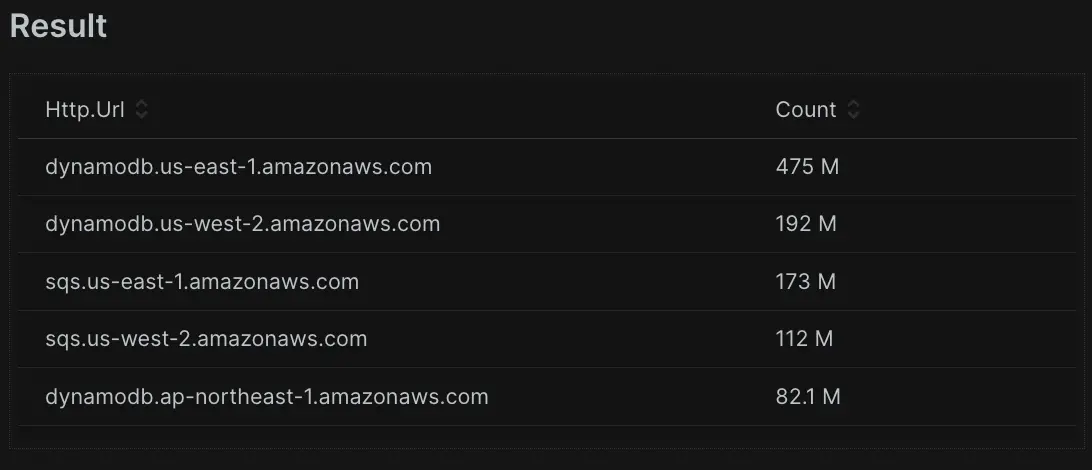
극도의 특이성이 필요하고 이름에 와일드카드를 사용하여 일치시킬 수 있는 공통 문자열이 없으면 어떻게 합니까? IN 및 NOT IN 연산자를 사용하면 속성에 대해 확인하려는 값 집합을 지정할 수 있습니다. AND 또는 OR 연산자를 사용하여 여러 WHERE 절을 지정하는 대신 쉼표로 구분된 괄호 안에 값을 나열하여 조건을 단순화할 수 있습니다.
이 샘플 쿼리에서는 하위 유형이 "graph.microsoft.com" 또는 "s3.amazonaws.com"인 트랜잭션 수를 계산할 수 있습니다. 대신 NOT IN 사용하도록 쿼리를 변경하면 하위 유형이 "graph.microsoft.com"이 아닌 트랜잭션 수를 얻게 됩니다. "s3.amazonaws.com"도 아닙니다.
SELECT count(*) FROM Public_APICall WHERE http.url IN ('graph.microsoft.com', 's3.amazonaws.com') SINCE 1 day ago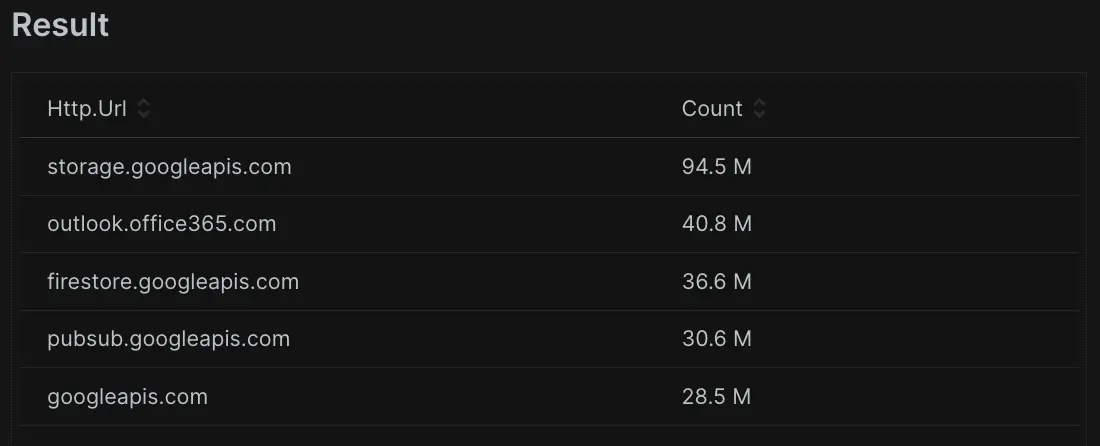
이제 데이터를 제어하고 필요에 맞게 조작하여 대시보드 및 알림을 구성할 수 있습니다. 다음으로 NRQL을 사용하여 시간 범위를 지정하는 방법을 알아봅니다.
시간 범위 지정
SINCE 및 UNTIL 절은 상대적인 시간 범위에 대한 정보를 제공하는 것 이상의 역할을 합니다. 특정 날짜나 시간을 지정할 수도 있습니다. 다음 샘플 쿼리에서는 YYYY-MM-DD 형식의 SINCE 날짜를 사용할 수 있습니다.
SELECT average(duration) FROM Public_APICall SINCE '2023-10-28' TIMESERIES MAX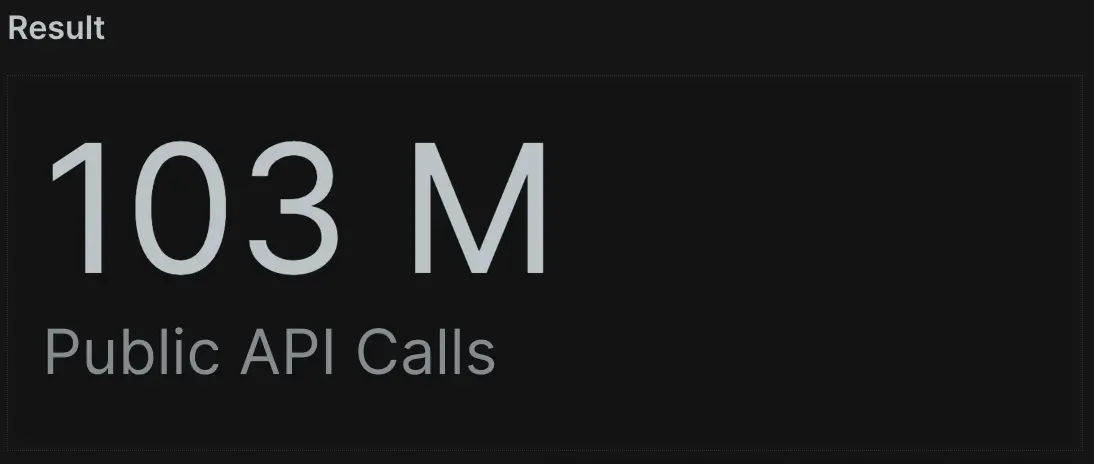
지정된 기간 동안의 SLA 보고서를 생성하는 데 이를 사용할 수 있습니다. YYYY-MM-DD HH:MM 형식으로 특정 시간을 포함할 수도 있습니다. 이 쿼리에서는 데이터가 18시로 설정된 것을 확인할 수 있습니다.
SELECT average(duration) FROM Public_APICall SINCE '2023-10-28 18:00' TIMESERIES MAX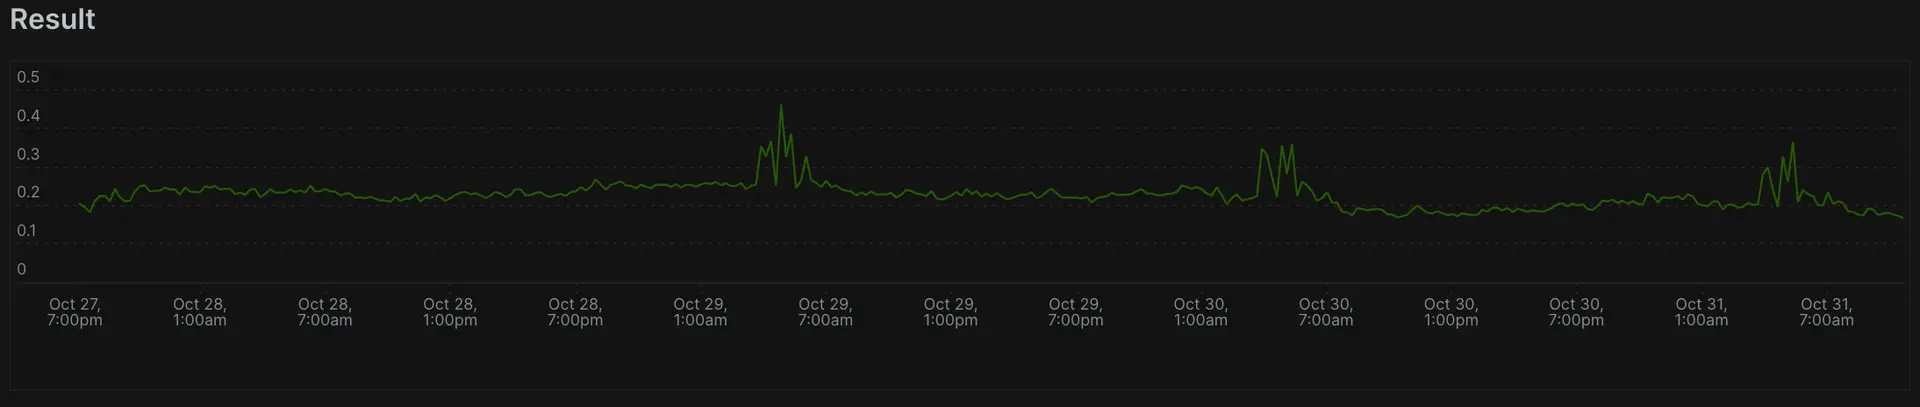
때로는 에포크(유닉스) 시간으로 이벤트 시간을 받을 수 있습니다. 이러한 값을 다른 날짜 형식으로 수동으로 변환할 필요가 없도록 SINCE 및 UNTIL 절과 함께 에포크 타임스탬프를 사용할 수도 있습니다.
SELECT average(duration) FROM Public_APICall SINCE 1698525489519 UNTIL 1698698289519 TIMESERIES MAX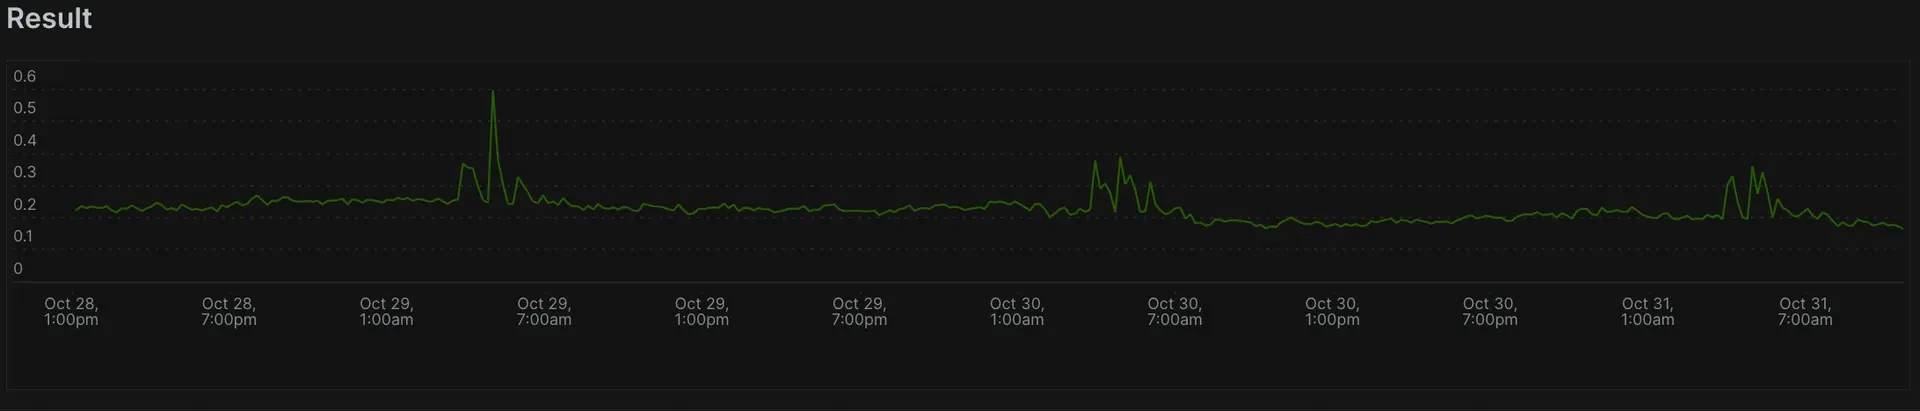
NRDB는 일정 기간 동안의 데이터를 표시할 때 사용자가 해당 시간대의 관점에서 데이터를 보길 원한다고 가정합니다. 그러나 여러 국가에 분산된 팀의 경우 위치에 따라 귀하의 오늘이 팀원의 내일일 수도 있고 어제일 수도 있습니다. WITH TIMEZONE 절을 사용하여 데이터를 표시할 시간대를 정의할 수 있습니다. 이는 SINCE 및 UNTIL 절의 값 해석에 영향을 미칩니다.
아래 두 가지 예시 차트를 살펴보세요. 각 쿼리에는 WITH TIMEZONE 사용하여 지정된 시간대가 있습니다. 둘은 8시간 간격이다. 데이터 패턴은 동일하지만 각 시간대에 맞춰 8시간의 오프셋을 가집니다.
SELECT count(*) FROM Public_APICall SINCE yesterday UNTIL today WITH TIMEZONE 'America/Los_Angeles' TIMESERIES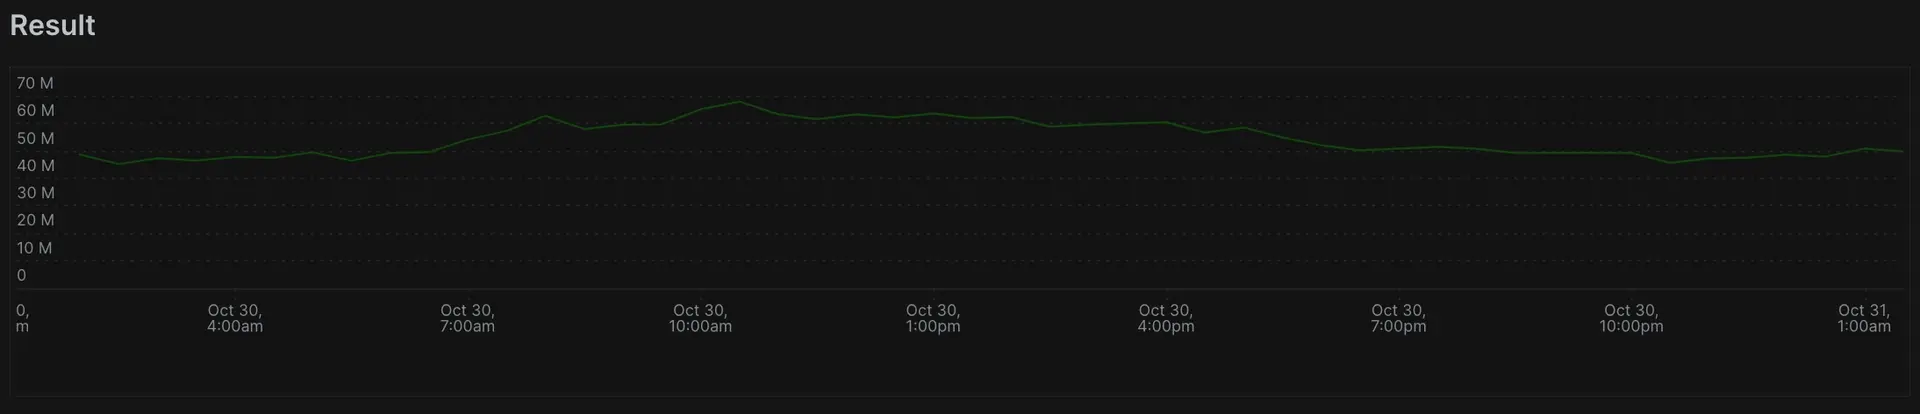
SELECT count(*) FROM Public_APICall SINCE yesterday UNTIL today WITH TIMEZONE 'Europe/London' TIMESERIES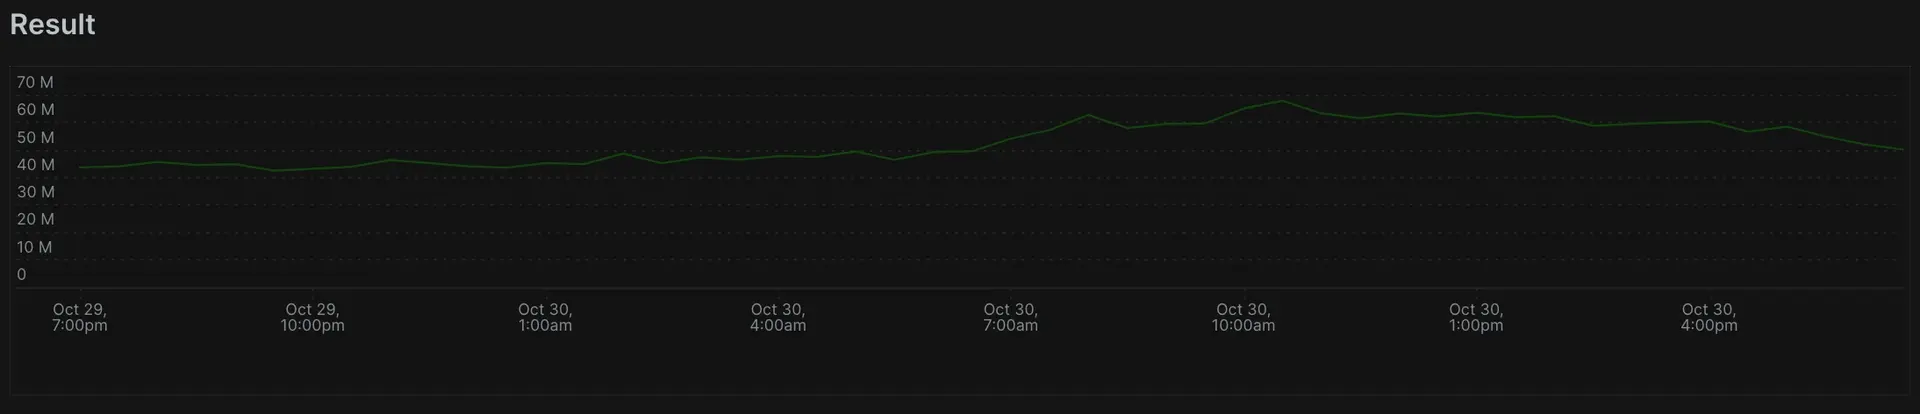
이 학습 이전에는 모든 시간 제어 메커니즘이 현재를 기준으로 한 상대적인 시간에 의존했습니다. 이제 전 세계 누군가의 위치에 따라 보기를 조정할 수 있습니다. 동부 해안에 있는 고객이 서부 해안에 위치한 엔지니어링 팀에 문제를 보고할 수 있습니다. 팀은 대시보드를 구축하고 고객이 언급하는 시간대에 맞게 보기를 변환할 수 있습니다. 따라서 고객이 동부 해안 시간으로 9시에 문제를 보고하는 경우, 9시를 확인할 때 시간 차이를 머릿속으로 변환할 필요가 없도록 할 수 있습니다.
공지 이벤트의 특정 날짜에 집중해야 하고 현재 시간과 관련된 이동 시간 창 없이 데이터를 조사하려는 경우, 이는 정적 시간 창에서 데이터를 얻는 데 도움이 됩니다. 다음이자 마지막 레슨에서는 시간 기반 코호트 분석을 통해 보고서에서 시간을 사용하는 방법을 계속해서 알아봅니다.
시간 기반 코호팅 사용
복잡해 보일 수도 있지만, 시간 기반 코호팅은 단지 데이터를 minuteOf, hourOf, weekOf 등과 같은 시간 기반 그룹으로 구성하는 방법을 의미할 뿐입니다.
기간에 SINCE 절을 사용하면 쿼리된 전체 기간을 검색합니다. 하지만 해당 데이터가 항상 모든 것을 말해주는 것은 아닙니다! 특정 기간 내의 성능을 더 면밀히 분석해야 한다면 어떻게 해야 합니까? 시간 기반 코호트 분석을 사용하면 데이터를 논리적인 시간 기반 그룹으로 추가 분류할 수 있습니다.
FACET 와 다양한 시간 기반 함수(예: hourOf(timestamp)) 중 하나를 조합하여 사용하면 일주일 동안의 데이터를 수집하고 해당 데이터가 발생한 특정 시간을 기준으로 성능을 이해할 수 있습니다. 이를 통해 추세를 파악하고 애플리케이션에 가장 중요한 시기를 식별합니다.
SELECT average(duration) FROM Public_APICall FACET hourOf(timestamp) SINCE 1 week ago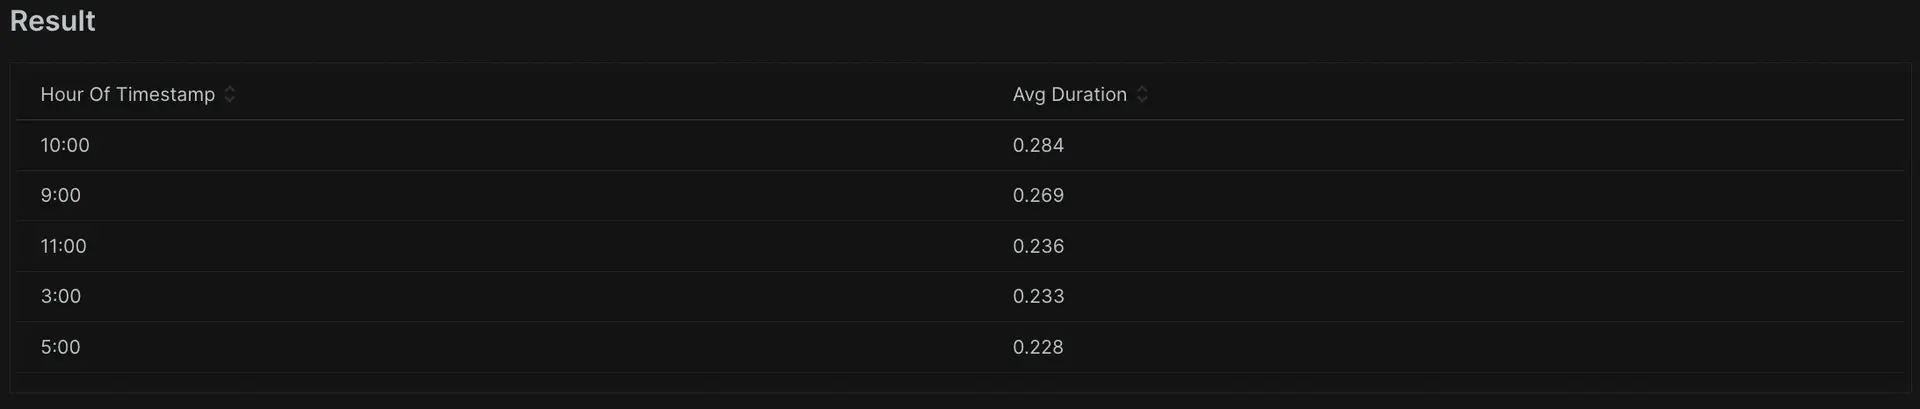
위의 쿼리를 실행한 후, 하루 중 시간을 기준으로 가장 느린 응답 시간을 확인할 수 있습니다. 뉴렐릭은 시간을 기준으로 패싯할 수 있는 다양한 옵션을 제공합니다. 이전 예제에서는 시간별로 그룹화했지만, 요일별로 그룹화하여 어느 요일의 응답 시간이 가장 좋고 가장 나쁜지 확인할 수도 있습니다.
SELECT average(duration) FROM Public_APICall FACET weekdayOf(timestamp) SINCE 1 week ago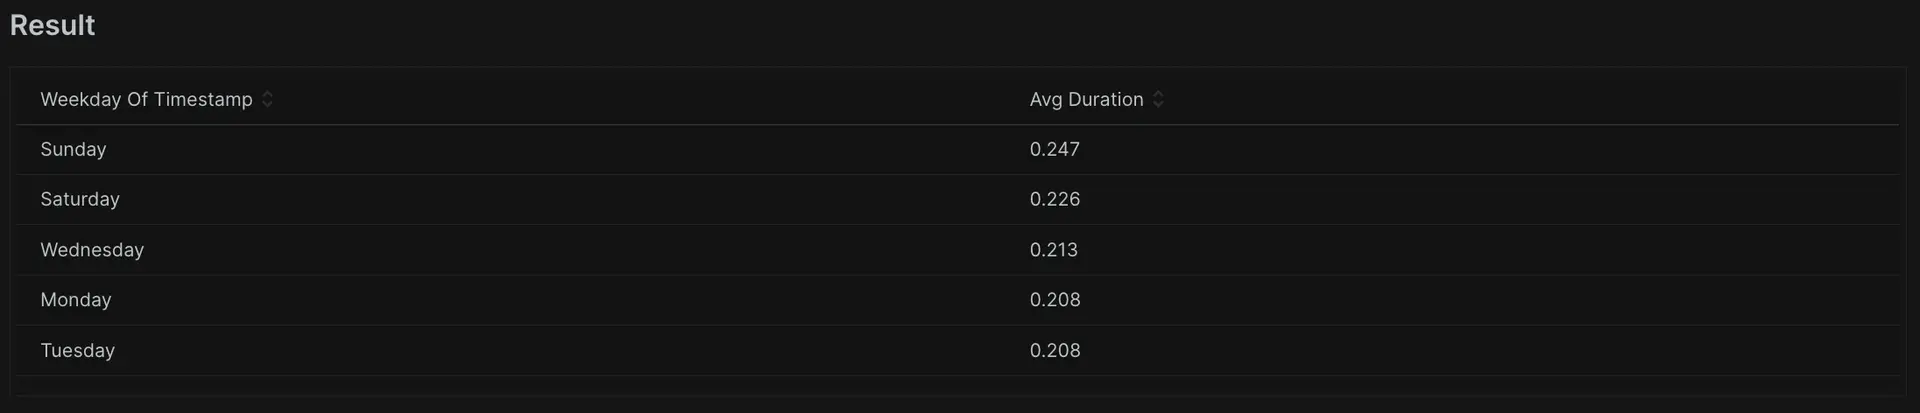
이제 특정 날짜에 가장 느린 애플리케이션 기간을 확인할 수 있습니다. 이를 사용하여 "언제 가장 많은 제품을 판매합니까?"와 같은 비즈니스에 중요한 질문에 답할 수 있습니다. 또는 "가입이나 로그인이 가장 많은 때는 언제입니까?"
특정 날짜별로 결과를 그룹화할 수도 있습니다. 이는 SLA 보고서를 고려하거나 특정 기간 동안의 성능 변화를 분석할 때 도움이 됩니다.
SELECT average(duration) FROM Public_APICall FACET dateOf(timestamp) SINCE 1 week ago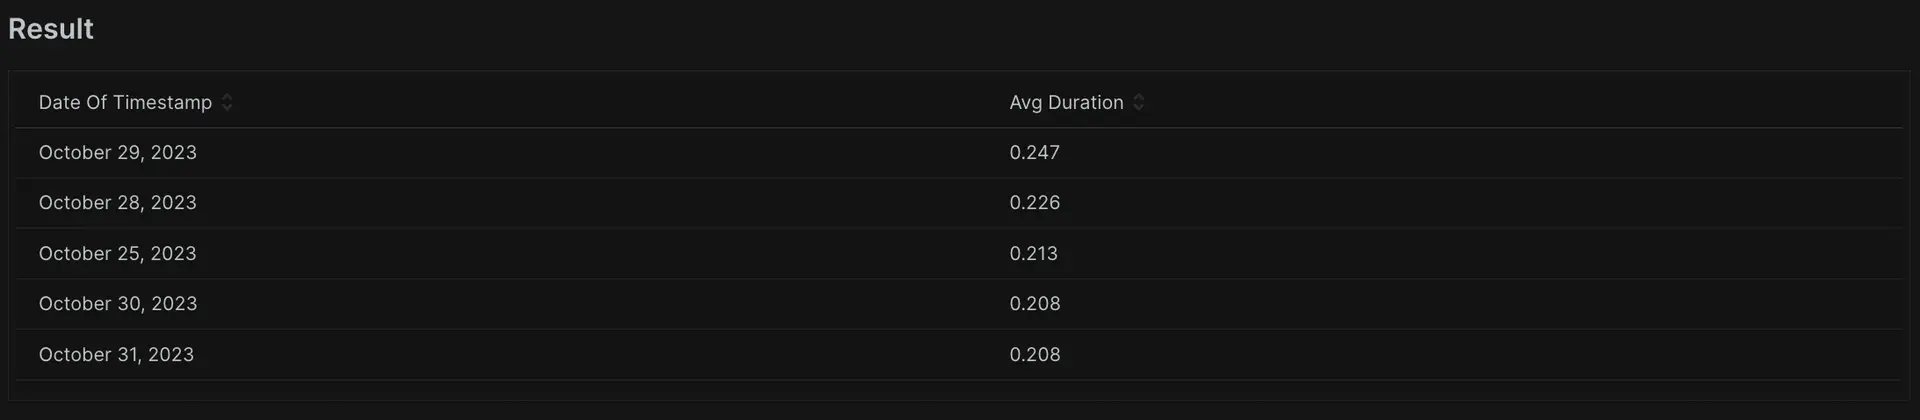
시간 기반 코호트 분석은 특정 분, 시간, 일 또는 주에 발생하는 문제를 노출합니다. 뉴렐릭에 어떤 데이터를 전송하든 NRQL을 사용하면 필요한 형식으로 데이터를 분할, 분석, 구성 및 시각화할 수 있습니다.
데이터 보존에 따라 주, 월, 연도를 포함하여 그룹화할 수 있는 다른 많은 옵션도 있습니다. 전체 목록을 보려면 시간 경과에 따른 결과 그룹화 문서 페이지를 참조하십시오.
다음 단계
여기서 얻은 지식을 바탕으로 대시보드 시각화를 생성하고 가장 관심 있는 데이터 측면을 제어할 수 있습니다. 이러한 기술을 사용하여 초점을 좁혀 더 세분화되고 구체적인 알림을 만들고 더 상세한 시각화를 생성할 수 있습니다. 준비가 되면 세 번째 튜토리얼로 넘어가 필터, 패싯 케이스, 히스토그램, apdex, eventTypes 필터링, 값 재정의 및 외삽을 포함한 추가 NRQL 기술을 배울 수 있습니다.